
EE7402-Statistical-Signal-Processing-Part2-4-已知参数的随机信号决策
引入
在前面的学习中,我们已经解决了已知参数的确定信号在噪声中的检测问题。
但是信息源产生的信息或许不是确定的,例如0和1的出现在信息中或许服从某一分布特征,但总的来说是随机出现的。因此,这里需要已知参数的随机信号在噪声中的检测来解决。
再举个例子,语音信号的波形取决于说话者是谁,说话者正在说的内容的上下文,说话者的健康情况等等。此时语音信号就是随机的,但它具有已知的协方差结构。
本章节将会聚焦于这个主题。
估计器 - 相关器(Estimator-Correlator)
估计器相关器旨在检测未知信号是否存在。其本质是在检测信号的能量。对于白信号,其检测的直接就是是否包含白信号的能量。而对于有色信号,其检测的是加权能量。故其又称能量检测器。
能量检测器(Energy Detector)
是什么
能量检测器是一种用于检测未知信号是否存在的检测器,核心作用是通过分析接收信号的能量大小,判断 “某种信号 + 噪声”和 “仅噪声”的场景。能量检测器是基于NP方法的。
标准的(非加权)能量检测是估计器 - 相关器在 “白信号” 场景下的特例。下面将建模一个例子来看能量检测器。
假设一个信号模型
假设信号是零均值、白、宽平稳(WSS)的高斯随机过程,方差为(\sigma_s^2)。此时信号本质是 “白高斯噪声(WGN)”(任意两个不同时刻的样本独立,功率谱平坦),但为了区分 “噪声” 概念,仍称其为 “信号”。
假设噪声是白高斯噪声(WGN),方差为(\sigma^2)(与信号独立)。
我们此时需要检测某一观测量是含信号的,还是不含的:
- 零假设(\mathcal{H}_0):接收信号(x[n] = w[n])(仅噪声),(n = 0,1,\dots,N-1);
- 备择假设(\mathcal{H}_1):接收信号(x[n] = s[n] + w[n])(信号 + 噪声),(n = 0,1,\dots,N-1)。
似然比
我们使用NP准则来对这个信号模型进行裁决。NP 准则要求比较似然比 (L(\mathbf{x}) = \frac{p(\mathbf{x};\mathcal{H}_1)}{p(\mathbf{x};\mathcal{H}_0)}) 与阈值(\gamma),若(L(\mathbf{x}) > \gamma)则判决(\mathcal{H}_1)。对于我们上面假设的信号模型:
- 若(\mathcal{H}_0)成立,(\mathbf{x} \sim \mathcal{N}(\mathbf{0}, \sigma^2 \mathbf{I}))(均值为 0、协方差为(\sigma^2)单位矩阵的高斯分布);
- 若(\mathcal{H}_1)成立,(\mathbf{x} \sim \mathcal{N}(\mathbf{0}, (\sigma_s^2 + \sigma^2) \mathbf{I}))(均值为 0、协方差为(\sigma_s^2 + \sigma^2)单位矩阵的高斯分布)。
然后我们将似然比的通式写出来:
由于似然比最后的结果含有$\exp$,我们使用对数似然比$l(x)$来表达:
首先给$L(\mathbf{x})$变形,方便取对数:
系数部分可利用幂运算性质 (\frac{a^k}{b^k} = \left( \frac{a}{b} \right)^k) 化简:
指数部分的指数项可合并为:
取对数求得$l(x)$:
如果我们将与$x[n]$无关的项都移动到右边,即可得到针对$x[n]$的阈值$\gamma’$
似然比检验变为若(\sum_{n=0}^{N-1} x^2[n] > \gamma’),则裁决为$H_1$
从对数似然比看出检验统计量
由对数似然比(ln Likehood Ratio, LLR)可以看出:
判决规则最终可简化为比较能量统计量 (T(\mathbf{x}) = \sum_{n=0}^{N-1} x^2[n]) 与新阈值$\gamma’$,即若(T(\mathbf{x}) > \gamma’)则判决(\mathcal{H}_1)。NP 检测器通过计算接收信号的能量(即平方和(\sum x^2[n]))并与阈值比较来判决,因此称为能量检测器。
由于我们此前假设的信号和噪声方差都是0,且独立同分布,因此观测量是一个零均值随机变量,其方差定义为:(\text{Var}(X) = \mathbb{E}[X^2]),对于一组独立同分布(i.i.d.)的样本 (x[0], x[1], \dots, x[N-1]),根据大数定律:当样本量 N 足够大时,样本均值会收敛到理论期望,那么信号的能量期望是:
即,接收信号 (x[n]) 的方差为:(\text{Var}(x[n]) = \mathbb{E}[x^2[n]])
这说明能量检测本质上也可理解为方差检测。只需要将$\gamma’$前面乘一个$\frac{1}{N}$,即可将其变为方差检测。
转换为卡方分布,看看$P_D$
由于(x[n])在两个假设下都是高斯分布,因此(T(\mathbf{x}))是N 个独立高斯变量的平方和,服从卡方分布:
(\mathcal{H}_0)下:(\frac{T(\mathbf{x})}{\sigma^2} \sim \chi_N^2)(自由度为N的卡方分布);
(\mathcal{H}_1)下:(\frac{T(\mathbf{x})}{\sigma_s^2+\sigma^2} \sim \chi_N^2)(自由度为N的卡方分布)。
这里的 “归一化” 操作是为了让平方和中的每个变量服从(\mathcal{N}(0,1))分布,从而满足卡方分布的定义。
与高斯分布的尾数函数类似,卡方分布的尾数函数 (Q_{\chi^2_\nu}(x)),其定义为:(Q_{\chi^2_\nu}(x) = \int_x^\infty p(t) dt)。其中(p(t))是自由度为(\nu)的卡方分布概率密度函数。
虚警概率是 在(\mathcal{H}_0)条件下“(T(\mathbf{x}) > \gamma’)” 的概率:
检测概率是在(\mathcal{H}_1)条件下“(T(\mathbf{x}) > \gamma’)” 的概率:
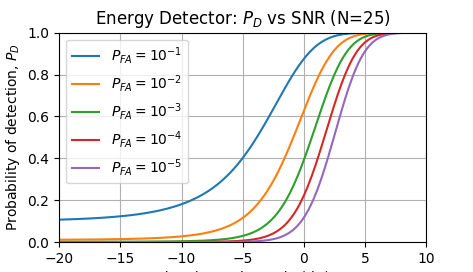
信噪比分析
SNR是信号与噪声的能量比,信号由于信号的均值为0,其能量$E[s^2[n]]$就等于方差$\sigma_s^2$;同理,噪声的能量就是其方差$\sigma^2$。因此:
那么$P_D$可以重写为:
由于(Q_{\chi^2_N}(x))是x的递减函数(右尾概率随积分下限增大而减小),因此(P_D)随(\text{SNR})增大而单调递增—— 即 SNR 越高,能量检测器的检测性能越好。
泛化为估计器-相关器
此前的能量检测器假设信号是白信号(自相关为$\delta$函数,协方差矩阵为对角阵),现在将模型拓展到非白信号(有色信号)。对于非白信号,这种使用NP方法的检验手段就变回了估计器-相关器,此时检测的是加权能量,而非单纯的标准能量。这个加权能量将在下小节中详细讨论。
信号模型
假设信号(s[n])是零均值高斯随机过程,多次采样的协方差矩阵为(\mathbf{C}_s)(即信号在不同时刻可以相关,切割功率谱非平坦)。
假设噪声仍为加性噪声仍为白高斯噪声,方差(\sigma^2),协方差矩阵为(\sigma^2 \mathbf{I})((\mathbf{I})为单位矩阵)。
那么假设$H_0$和$H_1$服从:
- 零假设(\mathcal{H}_0)(仅噪声):(\mathbf{x} \sim \mathcal{N}(\mathbf{0}, \sigma^2 \mathbf{I}));
- 备择假设(\mathcal{H}_1)(信号 + 噪声):(\mathbf{x} \sim \mathcal{N}(\mathbf{0}, \mathbf{C}_s + \sigma^2 \mathbf{I}))。
计算似然比
根据n维高斯分布的PDF公式:
单位矩阵的行列式(|\mathbf{I}| = 1),而标量乘以矩阵的行列式满足(|k\mathbf{A}| = k^N |\mathbf{A}|)(k为标量,(\mathbf{A})为(N \times N)矩阵)。所以标量乘以单位矩阵再求行列式,就是标量的N次方。
单位矩阵的逆矩阵还是单位矩阵
(\mathcal{H}_0)下的 pdf:(p(\mathbf{x};\mathcal{H}_0) = \frac{1}{(2\pi\sigma^2)^{N/2}} \exp\left( -\frac{1}{2\sigma^2} \mathbf{x}^T (\sigma^2\mathbf{I})^{-1} \mathbf{x} \right));
(\mathcal{H}_1)下的 pdf:(p(\mathbf{x};\mathcal{H}_1) = \frac{1}{(2\pi)^{N/2} |\mathbf{C}_s + \sigma^2 \mathbf{I}|^{1/2}} \exp\left( -\frac{1}{2} \mathbf{x}^T (\mathbf{C}_s + \sigma^2 \mathbf{I})^{-1} \mathbf{x} \right))。
尝试将似然比化简,并写出对数似然比来求$\gamma’$:
对于系数部分:
因此似然比可以表达为:
将似然比转化为对统计量的比较
取ln:
对于后面这一坨$\left( -\frac{1}{2} \mathbf{x}^T (\mathbf{C}_s + \sigma^2 \mathbf{I})^{-1} \mathbf{x} + \frac{1}{2} \mathbf{x}^T (\sigma^2 \mathbf{I})^{-1} \mathbf{x} \right)$,将(\frac{1}{2} \mathbf{x}^T)和(\mathbf{x})提取出来:
若多项中含有相同的矩阵或向量因子,且因子在乘法中位置(左乘 / 右乘)一致,则可将其提取到括号外。具体到 “二次型”(形如(\mathbf{x}^T \mathbf{A} \mathbf{x})的表达式,其中(\mathbf{x})是向量,(\mathbf{A})是矩阵),提取公因式的规则如下:
若有两个二次型(\mathbf{x}^T \mathbf{A} \mathbf{x})和(\mathbf{x}^T \mathbf{B} \mathbf{x}),则:(\mathbf{x}^T \mathbf{A} \mathbf{x} + \mathbf{x}^T \mathbf{B} \mathbf{x} = \mathbf{x}^T (\mathbf{A} + \mathbf{B}) \mathbf{x})
此时有:
把$\ln\left[\frac{ \sigma^N }{ |\mathbf{C}_s + \sigma^2 \mathbf{I}|^{1/2} }\right]$移到$\gamma’$这一侧,变成$\gamma’’$。似然比检测可以写为
将对数似然比的判决条件两边乘以(2\sigma^2)(消去系数(\frac{1}{2})),得到:
令新的检验统计量(T(\mathbf{x}) = \sigma^2 \mathbf{x}^T \left( \frac{1}{\sigma^2} \mathbf{I} - (\mathbf{C}_s + \sigma^2 \mathbf{I})^{-1} \right) \mathbf{x}),则判决条件为:(T(\mathbf{x}) > 2 \gamma’ \sigma^2)。我们进一步对$T(\mathbf{x})$来进行化简。
使用矩阵逆公式:
令(\mathbf{A} = \sigma^2 \mathbf{I}),(\mathbf{B} = \mathbf{D} = \mathbf{I}),(\mathbf{C} = \mathbf{C}_s),代入后可得:
单位矩阵与自身相乘仍为单位矩阵:(\mathbf{I} \cdot \mathbf{I} = \mathbf{I});
单位矩阵(\mathbf{I})与任何同阶矩阵(\mathbf{B})相乘时,结果仍为(\mathbf{B}),即:(\mathbf{I} \cdot \mathbf{B} = \mathbf{B} \cdot \mathbf{I} = \mathbf{B})
标量(如(\frac{1}{\sigma^2}))与矩阵的乘法满足交换律,即标量可自由移到矩阵乘法的任意位置,不影响结果。因此:(\frac{1}{\sigma^2} \mathbf{I} \cdot \mathbf{B} \cdot \frac{1}{\sigma^2} \mathbf{I} = \frac{1}{\sigma^2} \cdot \frac{1}{\sigma^2} \cdot \left( \mathbf{I} \cdot \mathbf{B} \cdot \mathbf{I} \right))
那么:
现实的系统实现:Wiener 滤波
令(\hat{\mathbf{s}} = \frac{1}{\sigma^2} \left( \frac{1}{\sigma^2} \mathbf{I} + \mathbf{C}_s^{-1} \right)^{-1} \mathbf{x}),则检验统计量可表示为:
其中(\hat{\mathbf{s}})是Wiener 滤波对信号(\mathbf{s})的最优估计(利用了信号的协方差结构(\mathbf{C}_s))。
因此,该检测器的逻辑是:先通过 Wiener 滤波估计信号(\hat{\mathbf{s}}),再将估计结果与接收数据(\mathbf{x})做相关运算—— 这就是 “估计器 - 相关器” 名称的由来(先估计信号,再做相关)。

对估计器-相关器进一步讨论
在白信号时退化为单纯能量检测
如果信号是白信号,那么$\mathbf{C}_s=\sigma^2_s\mathbf{I}$。代入$\hat{\mathbf{s}} = \frac{1}{\sigma^2} \left( \frac{1}{\sigma^2} \mathbf{I} + \mathbf{C}_s^{-1} \right)^{-1} \mathbf{x}$,
因此:(\hat{\mathbf{s}} = \frac{\sigma_s^2}{\sigma_s^2 + \sigma^2} \mathbf{x})。对应到每个时刻的样本,有:(\hat{s}[n] = \frac{\sigma_s^2}{\sigma_s^2 + \sigma^2} x[n])
此时我们再来看泛化后的判决$T(\mathbf{x})$:
似然比检验两边同时乘以(\frac{\sigma_s^2 + \sigma^2}{\sigma_s^2})(因(\sigma_s^2 > 0),不等号方向不变),得到:
此时的检验统计量本质是接收信号的能量(平方和(\sum x^2[n]))乘以一个固定比例因子,最终的判决条件等价于 “能量超过新阈值”—— 这与之前的能量检测器完全一致。
这说明:当信号是白噪声时,估计器 - 相关器会退化为能量检测器,验证了泛化框架的合理性(能量检测器是估计器 - 相关器的特例)。
在有色噪声时进行加权能量检测
1.为何是加权能量检测?
考虑对有色噪声进行2次观测(N=2)的场景,信号(s[n])的协方差矩阵为:(\mathbf{C}_s = \sigma_s^2 \begin{bmatrix} 1 & \rho \\ \rho & 1 \end{bmatrix})。其中(\rho)是(s[0])和(s[1])的相关系数((-1 < \rho < 1)),表示两个时刻信号的相关性。
根据前面推广得到的,对于有色噪声的阈值判别为:
矩阵的特征分解(Eigen-decomposition),也称为谱分解(Spectral Decomposition),是将一个矩阵分解为其特征值和特征向量的乘积形式的过程。它是线性代数中分析矩阵结构、简化矩阵运算的核心工具之一,在信号处理、机器学习、物理建模等领域有广泛应用。
对于一个(n \times n)的矩阵(\mathbf{A}),如果存在一个标量(\lambda)和一个非零向量(\mathbf{v}),使得:(\mathbf{A} \mathbf{v} = \lambda \mathbf{v}),则称(\lambda)是(\mathbf{A})的特征值,(\mathbf{v})是(\mathbf{A})对应于(\lambda)的特征向量。
对于一个可对角化的矩阵(\mathbf{A})(即存在n个线性无关的特征向量),可以分解为:(\mathbf{A} = \mathbf{V} \mathbf{\Lambda} \mathbf{V}^{-1})
其中:
- (\mathbf{V}):由(\mathbf{A})的特征向量作为列组成的矩阵(称为模态矩阵或特征向量矩阵);
- (\mathbf{\Lambda}):对角矩阵,对角线上的元素是(\mathbf{A})的特征值(按与(\mathbf{V})中特征向量的对应顺序排列);
- (\mathbf{V}^{-1}):(\mathbf{V})的逆矩阵。
为简化计算,利用特征分解对协方差矩阵(\mathbf{C}_s)进行变换:
协方差矩阵(\mathbf{C}_s)的模态矩阵(\mathbf{V})由其特征向量组成,特征值矩阵(\mathbf{\Lambda}_s)由其特征值组成。(特征分解的性质:(\mathbf{C}_s = \mathbf{V} \mathbf{\Lambda}_s \mathbf{V}^T),且(\mathbf{V}^T \mathbf{V} = \mathbf{I})(正交矩阵))
模态矩阵(\mathbf{V} = \begin{bmatrix} \frac{1}{\sqrt{2}} & \frac{1}{\sqrt{2}} \\ \frac{1}{\sqrt{2}} & -\frac{1}{\sqrt{2}} \end{bmatrix}):
特征值矩阵(\mathbf{\Lambda}_s = \sigma_s^2 \begin{bmatrix} 1+\rho & 0 \\ 0 & 1-\rho \end{bmatrix}):
令(\mathbf{y} = \mathbf{V}^T \mathbf{x}),由于正交矩阵的逆等于其转置($\mathbf{V}^{-1}=\mathbf{V}^T$),(\mathbf{x} = \mathbf{V} \mathbf{y})。将其代入检验统计量:
由于(\mathbf{V})是正交矩阵,满足(\mathbf{V}^T \mathbf{V} = \mathbf{V} \mathbf{V}^T = \mathbf{I}),因此可以先化简为:
根据矩阵逆的性质((\mathbf{ABC})^{-1} = \mathbf{C}^{-1} \mathbf{B}^{-1} \mathbf{A}^{-1}),而由于$\mathbf{V}^{-1}=\mathbf{V}^T$:
令(\mathbf{B} = \mathbf{\Lambda}_s \left( \mathbf{\Lambda}_s + \sigma^2 \mathbf{I} \right)^{-1}),则检验统计量可表示为:
现在来求一下$\mathbf{B}$,由于(\mathbf{\Lambda}_s = \sigma_s^2 \begin{bmatrix} 1+\rho & 0 \\ 0 & 1-\rho \end{bmatrix}),(\mathbf{\Lambda}_s + \sigma^2 \mathbf{I})为:
对角矩阵的逆矩阵是其对角元素取倒数后构成的对角矩阵,因此:
会发现这个$\mathbf{B}$退化为了对角矩阵,这被称为解耦,这样之前协方差不为对角矩阵的信号通过线性变换被解耦成了对角矩阵的形式。将$\mathbf{B}$代入,把$T(\mathbf{x})$展开:
(\mathbf{y} = \mathbf{V}^T \mathbf{x})是对原始数据(\mathbf{x})的线性变换,其本质是通过模态矩阵(\mathbf{V})将相关的原始数据转换为不相关的(\mathbf{y})分量(因(\mathbf{\Lambda}_s)是对角矩阵,(y[0])和(y[1])不相关)。
检验统计量是对(\mathbf{y})各分量的加权能量和,权重由 “信号特征值” 和 “噪声方差” 共同决定 —— 因此称为加权能量检测器。
2.进一步讨论:推广到n维有色信号
有意思的是,变换后的数据(\mathbf{y})的协方差矩阵为:
其中(\mathbf{C}_x = \mathbf{C}_s + \sigma^2 \mathbf{I}),$\mathbf{C}_s = \mathbf{V} \mathbf{\Lambda}_s \mathbf{V}^T$,代入后:
当向(\mathbf{C}_s)添加标量矩阵(\sigma^2 \mathbf{I})时,新矩阵(\mathbf{C}_x = \mathbf{C}_s + \sigma^2 \mathbf{I})的特征向量与(\mathbf{C}_s)完全相同,仅特征值被缩放为(\lambda_{s_i} + \sigma^2)。因此,(\mathbf{V})也能对(\mathbf{C}_x)进行解相关。此时我们可以将上面维度为2的信号拓展成维度为N的信号。对于一个维度为N的信号,$T(\mathbf{x})$有:
权重(\frac{\lambda_{s_n}}{\lambda_{s_n} + \sigma^2})是变换域下的维纳滤波系数—— 在解相关后的空间中,维纳滤波的 “信号 - 噪声权衡” 体现为对每个解相关分量的加权。
这样最终的检验统计量是解相关后分量(y[n])的加权平方和,称为标准形式(Canonical Form)。其系统实现的流程框图为:

相关器-估计器的性能讨论
相关器估计器的性能是很难进行闭式表达后计算的。
因为估计器 - 相关器的检验统计量是独立(\chi^2_1)随机变量的加权和。多个独立(\chi^2_1)变量的加权和没有 “简单的缩放卡方分布” 形式,因此其概率密度函数(pdf)难以用闭式表达,导致性能分析复杂。
非白噪声下要求预白化处理
在非白噪声下,噪声的协方差矩阵为(\mathbf{C}_w),信号的协方差矩阵为(\mathbf{C}_s)。而信号的 Wiener 估计量为:(\hat{\mathbf{s}} = \mathbf{C}_s (\mathbf{C}_s + \mathbf{C}_w)^{-1} \mathbf{x})
由于噪声非白,需先对噪声 “预白化”(乘以(\mathbf{C}_w^{-1})),再与 Wiener 估计信号相关,得到检验统计量:
(\mathbf{C}_w^{-1})的作用是 “预白化” 噪声 (消除噪声的相关性,使其在变换后近似为白噪声);
广义高斯检测
在上一节中,讨论了在WGN在检测确定信号;在这一节中,讨论了在WGN中检测零均值随机信号。
一般来说,我们将现实中的信号建模为确定的成分+随机的成分。确定成分拥有非零均值,随机成分是零均值随机过程。且信号整体的协方差矩阵已知,噪声协方差已知。
这就引出了广义高斯检测问题:“General Gaussian Detection Problem”(广义高斯检测问题)是指在高斯统计框架下,对同时包含 “确定性分量” 和 “随机性分量” 的信号,在 “任意已知噪声协方差” 场景下的最优检测问题
模型与似然比通式
广义高斯检测模型建立
信号建模:将信号建模为确定性分量非零均值$\mu_s$和随机性分量(零均值、协方差(\mathbf{C}_s)),即(\mathbf{s} \sim \mathcal{N}(\mu_s, \mathbf{C}_s));
噪声建模:噪声(\mathbf{w} \sim \mathcal{N}(\mathbf{0}, \mathbf{C}_w)),且与信号(\mathbf{s})独立;
广义高斯检测的假设检验定义为:
检测依据:通过信号的均值(\mu_s)和协方差矩阵(\mathbf{C}_s)与噪声的差异来区分信号和噪声
似然比检验推导
判决(\mathcal{H}_1)当且仅当似然比$L(\mathbf{x}) = \frac{p(\mathbf{x};\mathcal{H}_1)}{p(\mathbf{x};\mathcal{H}_0)} > \gamma$。
- 当(\mathcal{H}_1)成立时,(\mathbf{x} \sim \mathcal{N}(\mu_s, \mathbf{C}_s + \mathbf{C}_w))
- 当(\mathcal{H}_0)成立时,(\mathbf{x} \sim \mathcal{N}(\mathbf{0}, \mathbf{C}_w));
那么,似然比就是:
取对数后保留与数据(\mathbf{x})相关的项(与观测无关的常数项放进$\gamma$里面):
展开((\mathbf{x} - \mu_s)^T (\mathbf{C}_s + \mathbf{C}_w)^{-1} (\mathbf{x} - \mu_s)):
代入对数似然并整理,得到:
通过$T’(\mathbf{x})$可以看到,其含线性项(与信号均值(\mu_s)相关)和二次项(与信号协方差(\mathbf{C}_s)相关),分别对应 “利用信号均值” 和 “利用信号相关性结构” 的检测逻辑。
特殊情况的退化
情况 1:(\mathbf{C}_s = 0)(纯确定性信号,(\mathbf{s} = \mu_s))
此时信号无随机性,仅含确定性均值。将(\mathbf{C}_s = 0)代入检验统计量(T’(\mathbf{x}))
物理意义:这是 “预白化 + 匹配滤波” 的形式 —— 先通过(\mathbf{C}_w^{-1})预白化噪声,再与确定性信号(\mathbf{s})匹配滤波,与非白噪声下的确定性信号检测结论一致。
情况 2:(\mu_s = 0)(纯随机信号,(\mathbf{s} \sim \mathcal{N}(\mathbf{0}, \mathbf{C}_s)))
此时信号无确定性均值,仅含随机性结构。将(\mu_s = 0)代入检验统计量(T’(\mathbf{x})):
其中(\hat{\mathbf{s}} = \mathbf{C}_s (\mathbf{C}_s + \mathbf{C}_w)^{-1} \mathbf{x})是信号的最小均方误差(MMSE)估计量
物理意义:这与之前 “非白噪声下的估计器 - 相关器” 结论一致 —— 通过 Wiener 滤波估计随机信号,再与预白化后的数据相关,实现最优检测。
一个例子
假设:
- 信号(s[n] \sim \mathcal{N}(A, \sigma_s^2)):是确定性均值A + 随机性方差(\sigma_s^2)的高斯信号(独立同分布,IID);
- 噪声(w[n] \sim \mathcal{N}(0, \sigma^2)):零均值、方差(\sigma^2)的白高斯噪声(独立同分布,IID);
观测数据为(x[n] = s[n] + w[n])((\mathcal{H}_1))或(x[n] = w[n])((\mathcal{H}_0))。
噪声协方差矩阵:(\mathbf{C}_w = \sigma^2 \mathbf{I})(白噪声,单位矩阵(\mathbf{I})缩放);
信号均值向量:(\mu_s = A \mathbf{1})((\mathbf{1})是全 1 向量,体现确定性均值A);
信号协方差矩阵:(\mathbf{C}_s = \sigma_s^2 \mathbf{I})(随机分量的方差,白信号结构)。
代入前面推导的$T’(\mathbf{x}) = \mathbf{x}^T (\mathbf{C}_s + \mathbf{C}_w)^{-1} \mu_s + \frac{1}{2}\mathbf{x}^T \mathbf{C}_w^{-1} \mathbf{C}_s (\mathbf{C}_s + \mathbf{C}_w)^{-1} \mathbf{x}$:
拆分成前后两项来看,方便化简。第一项:
其中(\mathbf{x}^T \mathbf{1} = \sum_{n=0}^{N-1} x[n]),因此该项可写为:$\frac{N A}{\sigma_s^2 + \sigma^2} \cdot \bar{x} \quad $
第二项:
(可以看到第二项是“能量检测器”的加权形式)
最终得到:
这个最终的表达式由:
- 第一项 “平均器”:利用信号的确定性均值A,通过样本均值xˉ检测信号的 “整体趋势”;
- 第二项 “能量检测器”:利用信号的随机性方差(\sigma_s^2),通过样本能量(\sum x^2[n])检测信号的 “随机波动”;
这一形式体现了广义高斯检测的核心思想 ——同时利用信号的 “均值(确定性)” 和 “协方差(随机性)” 结构,将复杂检测问题分解为两个直观的子检测模块(平均器和能量检测器)的加权和。