
EE6427-Video_Signgal_Processing-P2-Image_Compression&JPEG
引入
在图像与视频处理中,Compressing, Coding, Encoding都是指的一件事:通过某种编码方式,将图像或视频压缩成存储或传输效率更高的格式(信源编码)。
压缩由压缩率(Compression Ratio)来进行评价,其定义为压缩前的比特数($B_0$)/压缩后的比特数($B_1$).
图像压缩后可以变为多个符号,这些符号用熵来表示其信息量。例如符号集$S={s_1,s_2,…s_n}$,其熵为:
熵编码:霍夫曼编码
霍夫曼编码是JPEG中使用的编码形式。霍夫曼码是一种无损压缩的可变长编码,它根据统统计信息来分配码字。使得更频繁出现的信息有更短的码字,而不频繁出现的信息则占用更长的码字。以此实现无损压缩。
如何编码
横向写法
考虑这个例子,现在有$s_0-s_4$5个符号,他们出现的概率分别是:
| 符号 | $s_0$ | $s_1$ | $s_2$ | $s_3$ | $s_4$ |
|---|---|---|---|---|---|
| 概率 | 0.4 | 0.2 | 0.2 | 0.1 | 0.1 |
第一步:将符号从上到下按照概率从大到小排列,将概率写在stage1
第二步:将概率最小的两项加起来,在stage2重新从排列。如果加起来的概率与其他概率相等,则将其放在最前面。
第三步:重复步骤2,写出stage3
第四步:重复步骤2,写出stage4。此时只剩两项,可以停止。

第五步:给每一个分支上侧分配0,下侧分配1(也可以上1下0)。
第六步:根据每一个箭头,逆序写出每一层的码。以stage4到stage3为例:在stage4 0.6被分配了0,0.4被分配了1,那么stage3就需要把他们拿过来。stage3的第二个0.4需要先写stage4的0,再添上它自己的0;stage3的0.2需要先写stage4的0,再添上它自己的1。第一个0.4被分配了1,且其不是通过加合得到的,因此直接把1写到stage3就行。
第七步:重复第六步直到第一层。即可获得每个symbol的霍夫曼编码
霍夫曼树写法
假设有6个值,值分别为$a_1,a_2…a_6$,其对应的出现概率如下表
| a1 | a2 | a3 | a4 | a5 | a6 |
|---|---|---|---|---|---|
| 0.1 | 0.4 | 0.06 | 0.1 | 0.04 | 0.3 |
Step1:选出出现概率最小的两个,按照左大右小放置,将他们的概率加起来作为父节点
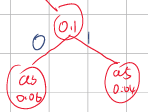
Step2.1:将概率1的父节点概率放回原来的数组,再次挑出概率最低的两个,此时Step1 父节点、a1、a4都是0.1可以随意选2个。这里以选择Step1 父节点和a4为例。父节点和a4还是按照左高右低放置,因为这里是等于,因此可以随意左右。
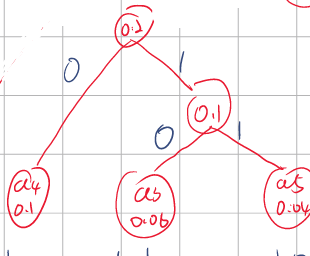
Step2.2:将这两个组合的父节点0.2再次放回,重复上一个步骤,会选出a1=0.1和父节点=0.2。还是按照左高右低放置,父节点和它的叶在左边。
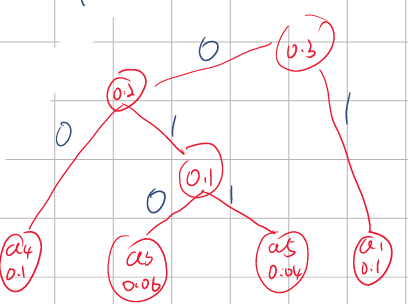
Step2.X:重复这个步骤,直到列表被选完。就可以得到霍夫曼树
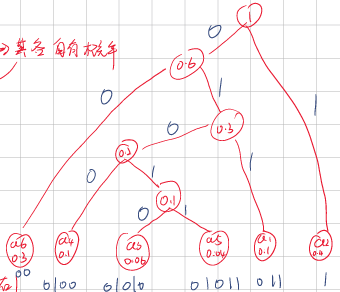
Step3:如上图,将每个父节点的左边标记0,右边标记为1;或者左边标记为1,右边标记为0。由父节点到最后的元素挨个顺下去,从左到右挨个记录01,就是该元素的霍夫曼编码值。
例如a1这个元素,首先从最大父节点顺下来:
1 这里靠左是0;
0.6这里靠右,是1;
0.3这里靠右,是1;
因此a1的霍夫曼编码值就是011。
例题1:
信息源包含八个符号(s₀ 到 s₇),每个符号的出现概率如下表所示,其中 m 和 n 是两个正实数。这些符号使用码本 A 中的码字进行编码:
| 符号 | s₀ | s₁ | s₂ | s₃ | s₄ | s₅ | s₆ | s₇ |
|---|---|---|---|---|---|---|---|---|
| 出现概率 | m | n | 0.15 | 0.10 | 0.08 | 0.06 | 0.05 | 0.02 |
| 码本 A 的码字 | 01 | 111 | 110 | 101 | 100 | 001 | 0001 | 0000 |
a) 若压缩方案的平均码长需小于 2.86,比特/符号,求 m 和 n 的取值范围。
平均码长由$L=\sum_{i=0}^7p_il_i$计算出,其中 $p_i$ 是符号出现概率,$l_i$ 是对应码字的长度。
平均码长为:
即,$L=2m+3n+1.45<2.86$。
同时,还要满足所有概率之和为1,即:
在这两个约束下,解得$m=0.54−n$, 带入另一个条件:
再带回$m=0.54−n$,得到$m>0.21$。故最终取值范围为:
b) m = 0.30 且 n = 0.24,讨论码本 A 的压缩效果。与霍夫曼编码进行比较,判断码本 A 是否为最优编码方案。
使用码本A编码的平均码长为:
如果使用霍夫曼编码,编码过程如下:

| 符号 | s₀ | s₁ | s₂ | s₃ | s₄ | s₅ | s₆ | s₇ |
|---|---|---|---|---|---|---|---|---|
| 出现概率 | 0.3 | 0.24 | 0.15 | 0.10 | 0.08 | 0.06 | 0.05 | 0.02 |
| 码本 A 的码字 | 11 | 01 | 101 | 001 | 000 | 1000 | 10011 | 10010 |
平均码长为:
$2.77>2.66$,因此霍夫曼编码更优。
例题2:
在一个压缩方案中,数据源由八个符号组成,其概率分布如下表所示。
| 符号 | S0 | S1 | S2 | S3 | S4 | S5 | S6 | S7 |
|---|---|---|---|---|---|---|---|---|
| 出现概率 | 0.02 | 0.05 | 0.08 | 0.10 | 0.14 | 0.16 | 0.19 | 0.26 |
(i) 为这八个符号设计一套合适的哈夫曼编码。请清楚展示关键步骤和计算过程。 (8 分)

(ii) 学生原本在未压缩方案中用 8 位表示每个符号。请计算在 (i) 部分设计的哈夫曼编码方案下的压缩比。 (6 分)
压缩后的平均码长为:
压缩率为:
(iii) 计算该数据源的熵。并简要讨论是否可能设计出平均码长小于 2.5 位/符号的编码方案。 (5 分)
信息熵为2.7333bits/symbol,2.5bits小于信息熵,因此不能。
图像的压缩
引入与基础
为什么有必要压缩:原始图像和视频文件的数据量非常巨大。例如,一段 1080P 的原始视频每分钟可能需要数 GB 的存储空间。压缩技术可以在保证画质的前提下,将文件体积压缩到原来的几十分之一甚至几百分之一,让存储设备能容纳更多内容。
为何图像视频可以被压缩?
图像压缩的原理是其中存在大量的冗余信息,我们可以通过算法去除这些冗余,同时不影响人眼的主观感受。
1.统计冗余 (Statistical Redundancy): 这是指数据本身存在的重复或可预测的模式。有以下三类
- 空间冗余 (Spatial Redundancy / 帧内冗余 intraframe redundancy):同一幅图像里,相邻像素的颜色和亮度通常非常相似。比如一张蓝天的图片,大片区域的像素值几乎一样。
- 时间冗余 (Temporal Redundancy / 帧间冗余):这是指时域上的冗余信息(特指视频)。视频是由连续的帧组成的,相邻两帧之间的内容变化通常很小。比如一个人在说话,只有嘴部在动,背景和人脸的大部分区域都是不变的。所以我们不需要存储每帧的完整图像,只需要存储第一帧的完整信息,后续帧只记录和前一帧的差异即可。
- 编码冗余 (Coding Redundancy):这是指在数据编码时,使用了过长的编码来表示出现频率高的符号。比如在一个图像中,白色像素出现的频率很高,如果我们用固定长度编码来表示所有颜色,就浪费了空间。更高效的做法是用变长编码(比如上面介绍的霍夫曼编码),给出现频率更高的数据编为更短的编码。
2. 视觉冗余 (Psycho-visual Redundancy):人类视觉系统的局限性,人眼对某些信息不敏感,我们可以在合理范围内丢弃这些信息。
- 频率掩蔽 (Frequency Masking):人眼对图像中的高频细节(即,图像变化剧烈的地方,比如精细的纹理、锐利的边缘)的噪声或失真不太敏感。所以压缩算法可以对高频信息进行更强烈的压缩,即使丢失一些细节,人眼也很难察觉。
- 颜色掩蔽 (Color Masking):人眼对亮度(Luma)的变化非常敏感,但对颜色(Chroma)的变化相对不敏感。基于这个原理,压缩时可以大幅降低颜色通道的分辨率,这样能减少大量数据,而人眼几乎看不出区别。
两种压缩类型:无损和有损
- 无损压缩(Lossless Compression):压缩和解压缩过程中不丢失任何信息,还原后的图像与原始图像完全一致。常见于重要数据,如医学影像。
- 有损压缩(Lossy Compression):压缩时会主动丢弃人眼 / 人耳无法感知或不敏感的信息,以换取更高的压缩比。解压后的图像与原始图像存在差异,但这种差异在主观上难以察觉。常见于消费级的多媒体内容,比如 JPEG 照片、MP3 音乐、H.264/H.265 视频。
如何量化压缩失真
均方误差 (Mean Squared Error, MSE)
其中,$xi$ 是原始图像的像素值,$yi$ 是压缩后重建图像的像素值,$N $是像素总数。它计算所有像素差值的平方的平均值,值越小表示失真越小。
信噪比(Signal to Noise Ratio, SNR)
其中,$\sigma^2_x$是原始图像像素值的方差(代表信号能量),$\sigma^2_d$ 是均方误差(代表噪声能量)。它以分贝(dB)为单位,值越大表示图像质量越好。
峰值信噪比 (Peak Signal to Noise Ratio, PSNR)
其中,$x_\max$ 是像素值的最大可能值(例如 8 位图像的 $x_\max=255$)。它是图像压缩中最常用的质量评价指标,值越高(通常大于 30dB 时),人眼就很难分辨出压缩后的失真。
基于变换的编码与压缩(Transform-based)
是什么
类似于对信号的傅里叶变换,图像也可以将其变换到“变换域”。在变换域中,可以对图像的不同部分进行“滤波”(例如图像频率,即,像素变化明暗交替的频率)。这是变换编码与压缩的核心工作机理。
变换带来的压缩优势:
- 能量压缩(Energy compaction):把图像的能量集中到少数几个变换系数中,大部分系数的值会趋近于 0,为后续压缩创造条件。
- 冗余减少(Redundancy reduction):原始图像的像素间存在很强的空间相关性,变换后这种相关性会被大幅削弱,变换系数之间近似独立。
- 可逆性:变换是一个可逆过程,通过逆变换(Inverse Transform) 可以从变换系数完全恢复出原始信号。
怎么做
一个变换压缩器总体分为以下几个步骤(以JPEG为例):
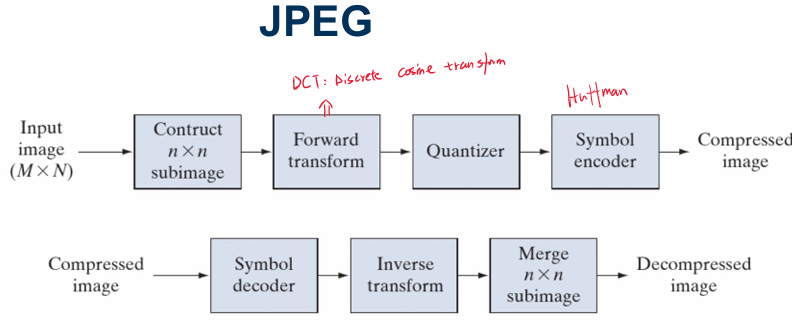
编码端:
- 分块:首先将一个较大的图像裁切为$n\times n$的小图。
- 前向变换:对每个图像块应用正交变换(如 DCT),得到变换系数矩阵。
- 量化(Quantization):对变换系数进行量化,这是一个不可逆的过程,也是对变换域进行“滤波”,产生有损压缩的主要环节。
- 编码(Coding):对量化后的系数进行熵编码(如霍夫曼编码),生成最终的二进制码流。
解码端:
符号解码(Symbol decoder):将二进制码流解码为量化后的变换系数。
逆变换(Inverse transform):对系数矩阵应用逆变换,重建出图像块。
合并子图像(Merge subimage):将所有重建的图像块合并成完整的图像。
在JPEG中,采用的是离散余弦变换(Discrete Cosine Transform,DCT),这也是下面即将深入介绍的。DCT可以将信号的能量压缩到一组较少的系数之中。
离散余弦变换(Discrete Cosine Transform,DCT)
引入:图像的频率
为了更好理解,将8x8的灰度图像简化为一个1x8的图像,按照图像的灰度值将这一行像素绘制在坐标轴上,即可得到这样的一个“信号”
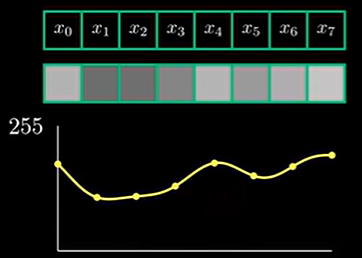
从这里可以看出,如果明暗交替越快,信号频率就越高。我们学过离散傅里叶变换,知道任何信号都可以使用正余弦叠加来还原,那么有没有可能能用各种余弦信号拟合出这个信号呢?是可以的,这就是DCT在干的事情。和DFT一样,在DCT中,变换后的位置存放直流信号强度,位置存放最高频信号强度,如下图所示。
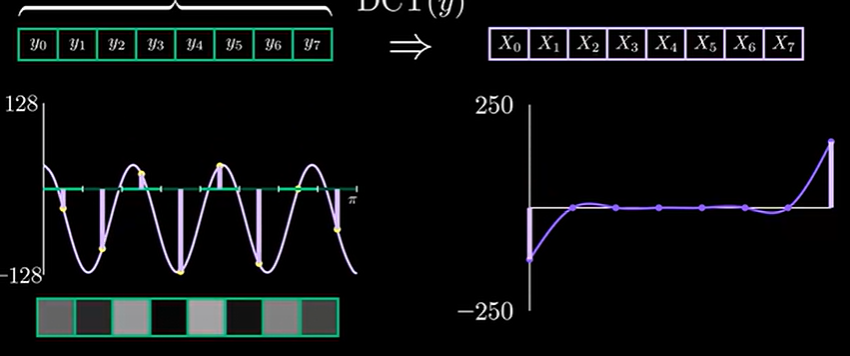
这一部分可以参看离散余弦变换可视化讲解_哔哩哔哩_bilibili,非常清晰。
引入-DCT的简介
2D-DCT(二维离散余弦变换)是基于变换的图像压缩中最主流、最成功的变换算法,也是 JPEG 等经典图像压缩标准的核心。
DCT 的核心优势
- 能量压缩(Energy compaction):它能将图像块的绝大部分能量集中到少数几个低频变换系数上,让高频系数的值趋近于 0。这为后续的量化和高效编码创造了极佳条件。
- 冗余减少(Redundancy reduction):原始图像像素间的空间相关性很强,经过 DCT 变换后,变换系数之间的相关性被大幅消除,变得近似独立。
- 固定基函数(Fixed basis functions):DCT 的基函数是固定的、与图像内容无关的,这意味着它不需要针对每幅图像重新计算基函数,计算复杂度低,易于硬件实现。
什么是基函数(basis functions)?
基函数是构成复杂信号的基础 “积木块”。任何一个复杂的图像信号,都可以被分解成一系列简单基函数的加权组合。就像用不同形状、颜色的乐高积木,可以拼出任何你想要的模型。DCT 的基函数是一系列不同频率的余弦波形。
一个 4×4 的图像块,就是由 16 个不同频率的 DCT 基函数($4\times4$),各自乘以一个对应的变换系数后,叠加而成的。如下图所示

在这个二维基函数中,纵轴用$u$表示,横轴用$v$表示。当u越大,其横向频率越高;当v越大,其纵向频率越高。
对于一个$4\times4$的图像像素矩阵,进行2D-DCT变换之后,将会得到上述$4\times4$基函数的各成分系数。而所谓DCT“固定基函数”的特性,就是对于$n\times n$的图像,
DCT的计算(标量法)
二维DCT的基本公式为:
其中,N是像素矩阵的维度(例如$4\times 4$)。$S_{uv}$是变换后DCT系数矩阵,u为纵轴(行),v为横轴(列);$s_{ij}$是原始像素矩阵,i为纵轴(行),j为横轴(列)。
举个例子:计算下列像素矩阵的2D-DCT:
首先,对于$4\times 4$矩阵,其$\alpha(k)$有:
观察像素矩阵A,发现其非零元素只有$s_{1,1}=10;s_{1,2}=10;s_{2,1}=10;s_{2,2}=10$。因此在求和时可以只考虑这4项。
1.计算直流分量$S_{0,0}$
2.计算$S_{0,1}$
- 对于$j=1$, $\cos\left(\frac{(2+1)\times 1\times \pi}{8}\right)\approx0.38268$
- 对于$j=2$, $\cos\left(\frac{(4+1)\times 1\times \pi}{8}\right)\approx-0.38268$
2.计算$S_{0,2}$
- 对于$j=1$, $\cos\left(\frac{(2+1)\times 2\times \pi}{8}\right)=-\frac{\sqrt 2}{2}$
- 对于$j=2$, $\cos\left(\frac{(4+1)\times 2\times \pi}{8}\right)=-\frac{\sqrt 2}{2}$
3.计算$S_{0,3}$
- 对于$j=1$, $\cos\left(\frac{(2+1)\times 3\times \pi}{8}\right)\approx -0.92388$
- 对于$j=2$, $\cos\left(\frac{(4+1)\times 3\times \pi}{8}\right)\approx 0.92388$
如此往复,最终会计算得到如下结果
DCT的计算(向量+2次变换)
除了直接使用2D-DCT的公式进行计算外,2D-DCT可以被拆分为先对列进行1D-DCT,再对结果的行进行1D-DCT;或先对行进行1D-DCT,再对结果的列进行1D-DCT。

对于先行1D-DCT,后列1D-DCT的2D-DCT,其计算公式为:
Stage1: 行DCT
Stage2: 列DCT
继续使用上面的例子,还是考虑像素矩阵A
首先对行进行1D-DCT,分别是:
- 首先观察$A_{0j}$和$A_{3j}$,因为他们是全0向量,因此$F_{0v}$和$F_{3v}$都是全0向量。
- 计算$A_{1j}$的1D-DCT
3.计算$A_{2j}$的1D-DCT
由于$A_{1j}=A_{2j}$,因此他们的1D-DCT结果相同,$\begin{matrix}
F_{2v}=[10&0&-10&0]
\end{matrix}$
因此对行进行1D-DCT后的矩阵为:
- 由于$F_{i1}$和$F_{i3}$为全0向量,因此$S_{u1}$和$S_{u3}$为全0向量。
- $F_{i0}=[0\ 10\ 10\ 0]^T$,其1D-DCT为:
因此$\begin{matrix}
S_{u0}=[10&0&-10&0]^T
\end{matrix}$
- 计算$F_{i2}==[0\ -10\ -10\ 0]^T$
因此$\begin{matrix}
S_{u2}=[-10&0&10&0]^T
\end{matrix}$
最终得到:
利用像素矩阵的合成计算DCT
在前面我们已经介绍了DCT的第一项表示直流分量。首先我们观察一个现象,假设对一个直流信号进行1D-DCT:
即,对于一个纯直流信号进行DCT,它的直流分量是信号均值的2倍。这个现象使得我们可以非常简单地计算直流DCT
将这个现象推广到2D-DCT,先对行进行1D-DCT,在对列进行1D-DCT,就有:
同时,在像素域的加减乘除关系在DCT域一样满足
利用这个现象,就可以来简化计算。考虑下面这个例子:
在前面的计算中,已经算得
利用这个结果,计算下列像素矩阵的DCT
观察可知:
因此,在DCT域,B的2D-DCT也等于20的直流信号的2D-DCT减去$\frac{1}{2}A$的2D-DCT
DCT的计算(矩阵法)
根据下面2D-DCT的公式,不难看出,当对像素矩阵内进行遍历时,$\cos$的值与$\alpha$的值针对某一$(i,j)$是一个定值。也就是说,完全可以将其预先计算好,写成一个矩阵,使用矩阵计算直接求得变换后的矩阵。
对于给定$n\times n$变换矩阵$\mathbf{T}$,$f(i,j)$为第$i$行$j$列像素值,正向变换为:
其中,变换矩阵$\mathbf{T}$为:
由于变换矩阵是正交的,$\mathbf{T}^T=\mathbf{T}^{-1}$,因此逆变换为:
例题:使用矩阵计算2D-DCT
一个 N×N 像素块的二维离散余弦变换矩阵定义如下(其中 $i,j $分别是行和列的索引。):
(i) 求一个 4×4 像素块的二维 DCT 矩阵 T,结果保留 4 位小数。
当 $i = 0$ 时,公式为 $\frac{1}{\sqrt{N}}$: $T(0, j) = \frac{1}{\sqrt{4}} = 0.5000$
当 $i = 1$ 时,公式为 $\sqrt{\frac{2}{4}} \cos\left(\frac{(2j+1)\pi}{8}\right) = \frac{1}{\sqrt{2}} \cos\left(\frac{(2j+1)\pi}{8}\right)$:
- $j=0: \frac{1}{\sqrt{2}} \cos\left(\frac{\pi}{8}\right) \approx 0.6533$
- $j=1: \frac{1}{\sqrt{2}} \cos\left(\frac{3\pi}{8}\right) \approx 0.2706$
- $j=2: \frac{1}{\sqrt{2}} \cos\left(\frac{5\pi}{8}\right) \approx -0.2706$
- $j=3: \frac{1}{\sqrt{2}} \cos\left(\frac{7\pi}{8}\right) \approx -0.6533$
当 $i = 2$ 时,公式为 $\frac{1}{\sqrt{2}} \cos\left(\frac{(2j+1)2\pi}{8}\right) = \frac{1}{\sqrt{2}} \cos\left(\frac{(2j+1)\pi}{4}\right)$:
- $j=0: \frac{1}{\sqrt{2}} \cos\left(\frac{\pi}{4}\right) = 0.5000$
- $j=1: \frac{1}{\sqrt{2}} \cos\left(\frac{3\pi}{4}\right) = -0.5000$
- $j=2: \frac{1}{\sqrt{2}} \cos\left(\frac{5\pi}{4}\right) = -0.5000$
- $j=3: \frac{1}{\sqrt{2}} \cos\left(\frac{7\pi}{4}\right) = 0.5000$
当 $i = 3$ 时,公式为 $\frac{1}{\sqrt{2}} \cos\left(\frac{(2j+1)3\pi}{8}\right)$:
- $j=0: \frac{1}{\sqrt{2}} \cos\left(\frac{3\pi}{8}\right) \approx 0.2706$
- $j=1: \frac{1}{\sqrt{2}} \cos\left(\frac{9\pi}{8}\right) \approx -0.6533$
- $j=2: \frac{1}{\sqrt{2}} \cos\left(\frac{15\pi}{8}\right) \approx 0.6533$
- $j=3: \frac{1}{\sqrt{2}} \cos\left(\frac{21\pi}{8}\right) \approx -0.2706$
(ii) 根据 (a)(i) 的结果,计算下列像素块 A 的二维 DCT,结果保留 3 位小数。
JPEG图像
引入
JPEG 是一种非常流行的图像压缩标准,它同时支持有损(lossy)和无损(lossless)图像压缩。压缩比通常在 10:1 到 20:1 之间。
它有4种编码模式:
- 基于 DCT 的顺序模式 (sequential DCT-based mode)
- 基于 DCT 的渐进模式 (progressive DCT-based mode)
- 无损模式 (lossless mode)
- 分层模式 (hierarchical mode)
我们将重点关注基于 DCT 的顺序模式,也就是基线 JPEG (baseline JPEG),因为它是 JPEG 中最普遍使用的模式。
基线 JPEG (baseline JPEG)的编码步骤:
- 图像/分块处理 (Image/block processing)
- 对图像块进行 DCT 变换 (DCT on image blocks)
- 量化 (Quantization)
- 熵编码 (Entropy coding)
- 帧构建 (Frame building)
下图是JPEG编码器的框图

- 输入:编码器输入为Y Cr Cb色域图像。对于Y通道,保留所有像素。对于Cr Cb通道,通常2x2的Y像素对应1个Cb和Cr。
- 图像/分块处理: 把输入图像分成 8x8 像素块。每个像素块独立执行后续的DCT和量化。
- 量化:根据量化表,将DCT的结果量化压缩到允许的范围内。
- Zigzag扫描:使用Zigzag扫描,将量化结果分为DC系数和AC系数两部分。
- 差分脉冲编码调制(DPCM)和游程编码(RLC):
- DPCM (差分脉冲编码调制):因为相邻图像块的平均亮度通常很接近,所以 DC 系数不直接编码,而是计算当前块与前一个块 DC 值的差值来进行编码,进一步减少数据量。
- RLC (游程编码, Run-Length Coding):由于 Zig Zag 扫描把量化后产生的大量 0 都串联在了一起,RLC 会记录“连续出现了几个 0,接着的非 0 值是什么”,这种方式能极其高效地压缩长串的 0。
- 熵编码:再次将出现频率高的数据用较短的二进制码表示,频率低的用较长的码表示,完成最后的无损压缩。
图像/块处理(Image/block processing)
JPEG其实支持以下输入,但Y, Cb, Cr是最常用的:
- Monochrome (单色/灰度图):只有一层矩阵,直接提取其亮度值进行压缩。
- CLUT (Color Look-Up Table, 颜色查找表):类似 GIF 格式的索引颜色图像,提取的是指向颜色表的索引值矩阵。
- R, G, B (红绿蓝)
- Y, Cb, Cr (亮度、蓝/红色度)

图像块中的DCT
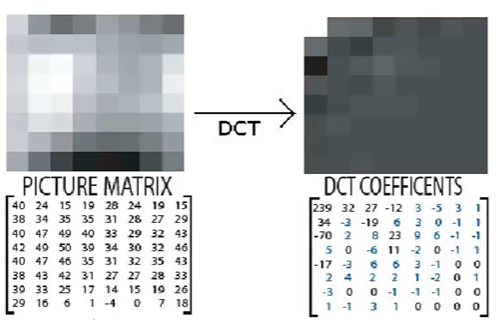
正向 2D-DCT 被应用于每一个 $8 \times 8$ 的像素块。
其中$C(\xi) = \begin{cases} \frac{\sqrt{2}}{2} & \text{if } \xi = 0 \\ 1 & \text{otherwise} \end{cases}$
它的DCT系数矩阵如下图所示。左上角那一个白色是DC系数,其余都是AC系数。
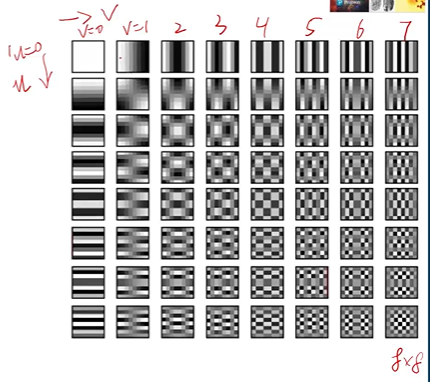
因为在8x8的图像内,像素信息不会发生太大的变化,可以确保低频信息占主导。下图可以看到低频信息强度较高,高频信息趋近于0。
量化
正向量化
人类的视觉系统 (Human Visual System) 对图像的低频部分(大面积的平缓亮度变化,即 DC 系数和左上角的低频 AC 系数)非常敏感 ,但对高频部分(局部的剧烈变化、噪点或细小纹理)很不敏感。
因此,我们在压缩时,对低频系数分配较小的“步长”(即除以较小的数字),以保留更多细节,减少量化误差;对高频系数分配极大的“步长”(除以很大的数字),使得它们在取整后直接变成 0。
量化表中的数值大小,直接决定了图像压缩率和画质损失之间的妥协 (compromise)。量化值越大,压缩率越高,画质越差。
量化的公式为:
其中,$F(u, v)$ 是你之前算出来的 DCT 系数,$Q(u, v)$ 是量化表中的对应数值,$round$ 是四舍五入取整操作。得到的 $\hat{F}(u, v)$ 就是准备送去编码的最终数据。
下面是用于亮度量化和色度量化的两张量化表:

举个例子,看下图的DCT系数矩阵和量化矩阵,以直流系数量化为例:

反向解压(Dequantization)
去量化的实则就是使用量化步长量化结果。例如前面直流分量的例子,量化表上的量化步长是10,量化结果是12。去量化恢复原始数值就是:
熵编码
zigzag扫描
在完成了量化之后,首先需要将量化出的矩阵展平,这样才方便编码。
我们希望把0连续地放在一起,这样在数据结尾直接放有“多少个0的”标识以节省空间(游程编码)。因此规定量化后数组的存储顺序为下图这样的蛇形,即,zigzag扫描。
zigzag扫描的路径如下图所示,DC分量被首先扫描,排在末尾。然后以蛇形扫描剩下的AC分量。低频的分量被存在一起;高频分量(0较多)被存在一起;这样就实现了把0放在一起利于编码。

DC差分编码(Differential Encoding)
对于一个图像,将其分成许多 8x8 的像素块,如果你没有连续的 8x8 像素块,你可以认为它们的平均亮度或强度非常相似。
因此,对于DC系数,编码的是当前块的 DC 系数与前一个块的 DC 系数之间的差值(预测误差)。
AC游程编码(Run-Length Encoding)
由于AC系数有大量的0,因此使用游程编码是更好的选择。
游程编码的输出是一个值对(value pair):(skip, value)。skip是接下来该值出现的个数,value是值。
举个例子:假设经过 Z 字扫描后的数组中间有一段是这样的:... 5, 0, 0, 0, 0, 0, 0, 12, ...
- 如果不压缩,需要存 8 个数字。
- 使用 RLE,我们只需存一个键值对:(6, 12)。这表示“跳过前面 6 个连续的 0,下一个非零数字是 12”。这就将原来需要大量空间的连续 0 极大地压缩了。
霍夫曼编码
在差分编码和游程编码之后,某些符号/模式的出现频率会高于其他符号。因此,使用霍夫曼编码 (Huffman coding) 来无损压缩这些符号。
帧构建( Frame building)
JPEG 为与图像/帧相关的比特流(bitstream)定义了语法。帧构建器 (frame builder) 的作用是将与编码图像相关的所有信息封装 (encapsulate) 到这种格式中。
- Start_of_image (SOI) 和 End_of_image (EOI)标记中夹着图像的帧。
- 每一帧由:
- Tables(各种表):存放量化表 (Quantization Tables) 和霍夫曼编码表 (Huffman Tables)。解码器必须先读取这些表,才能逆向还原数据。
- Header (文件头):包含了图像的基本参数,比如分辨率(宽x高)、色彩模式(YCbCr 还是灰度图)等。
- Scan (扫描层):包含了实际的图像数据流。在基线 JPEG 中通常只有一个 Scan,但在渐进式 JPEG 中会有多个 Scan(先传模糊轮廓,再传细节)。
- 在每一个Scan内部:
- Segment:由8x8的数据块组成。(也就是那个包含了 DC 差值和 AC 游程编码的二进制流)
- Restart 的作用:由于霍夫曼编码的长度是可变的,如果传输过程中丢失了一个比特,后面的数据就会全部错位(雪崩效应)。插入 Restart 标记可以把数据隔离开来。如果某一段损坏了,解码器可以跳过损坏的部分,从下一个 Restart 标记重新开始解码,从而防止整张图片完全花屏。

JPEG解码器
- Frame Decoder:将JPEG中所有的表拆分出来(霍夫曼表、量化表)
- Huffman Decoding:通过查霍夫曼编码表,将霍夫曼编码的数据恢复成原始数据
- 然后分别对DC和AC数据进行恢复,恢复成原始比特流
- Dequantizer:通过量化表把量化后的数据恢复成原始DCT系数
- IDCT:执行Inverse DCT恢复原始8x8数据块
- ImageBuilder:从所有像素块重建图像
