
EE6427-Video_Signgal_Processing-P4-AI_Models_&_Architecture
引入
深度学习模型
为何需要不同的深度学习架构?
- 因为不同的架构有不同的特性,可以在不同的领域应用。他们都是为了不同的特定问题设计的。
CNN: 最初,CNN 是为解决计算机视觉问题而开发的。CNN由不同的层组成,较浅的层会尝试提取一些简单的特征,如线条和边缘,等等,而后面的层会尝试提取更复杂和抽象的东西。CNN常用于分类任务。

RNN:RNN是一种专门用于处理序列的神经网络,常用于设计时间序列和状态序列预测建模中。(例如预测股票价格,语言翻译)。看到下图这个例子,x是输入,y是输出,h是隐藏层。当前的隐藏状态 h3,将取决于你当前的输入以及所有过去的输入被抽象出的h2。这就是它能处理序列信息的原因。

Transformer:一种使用注意力机制的并行处理输入序列的模型,在许多视觉和NLP应用中,这是最先进的模型。
所谓注意力机制,可以通过这个例子来理解:我给你一个词“mouse”,你会想到什么?老鼠,比如《猫和老鼠》里的卡通老鼠。也可能是这样的电脑鼠标。如果你只听到“mouse”这个词,这个“mouse”是什么意思呢?你如何理解这个单词的含义?你需要查看周围的单词,也就是所谓的上下文。注意力机制的理念是,你查看当前的单词,比如你试图替换的单词“mouse”,会查看它周围的单词,并了解这些单词对你当前的单词有多大的贡献或重要性。
Foundation Models:基础模型是通过大规模广泛数据训练的模型,经过微调之后,可以适配多种下游任务。常见的有LLMs(大语言模型),VLMs(视觉-语言模型)
人工神经元

人类神经元上,一个细胞可以通过轴突(Axon)发送信号给另一个细胞,另一个细胞使用树突(Dendrites) 接收并汇聚所有收到的信号后,进行处理。人类大脑中约有100亿个神经元,每个神经元有约1万个突触与其他神经元相连。(具体数据与解刨学有关,不一定准确)。

人工神经元与人类神经元类似,它接受多个输入,且针对每个输入有一个权重值,将输入加权求和后,放入“激活函数”中,计算本神经元的输出,将其输出给下一神经元。
其中这个激活函数是非线性的。为什么需要这个“激活函数”呢?因为早在信号与系统就学过,线性系统无法通过加减乘除变为非线性系统,因此一旦需要输出结果具有非线性特性,无论有多少个神经元协作,都无法实现非线性输出。因此在这里引入非线性的激活函数来使得系统具有非线性特征。常用的激活函数有Sigmoid, Tanh, RelU等等。
卷积神经网络(Convolutional Neural Network CNN)
多层感知器(Multiple Layer Perceptron MLP)
MLP
多层感知机是由多个感知机(Perceptron,也就是最基础的人工神经元)相互连接组成的网络,是深度学习最基础的网络结构之一。
它也叫Feed-Forward (FF) 前馈网络:数据从输入层到输出层单向流动,没有循环 / 反馈,和生物神经元的信号传递逻辑一致。
或Dense Network 全连接网络:每一层的每个神经元,都和上一层的所有神经元相连(图中密密麻麻的连线就是全连接的体现),每一条连线对应一个可学习的权重参数。

| 网络层级 | 作用 | 类比生物神经元 |
|---|---|---|
| 输入层 (Input layer) | 接收原始输入信号(比如传感器数据、图像像素、文本特征),不做计算,只负责传递数据 | 生物神经元的树突,负责接收外界信号 |
| 隐藏层 (Hidden layer) | 图中包含 2 层隐藏层,是网络的 “计算核心”:对输入做非线性变换,提取数据的抽象特征 | 神经元的胞体,对输入信号做加权求和 + 激活,产生输出 |
| 输出层 (Output layer) | 输出最终预测结果(分类概率、回归数值等) | 神经元的轴突,把处理后的信号传递给下一个神经元 |
线性分类器
线性分类器是最简单的分类模型,也是 MLP 的 “基础单元”:它基于输入数据的线性组合做分类决策,本质是用一个超平面对数据做划分。
我们用 3×4 的简化猫猫图像举例:

- 输入图像的像素被展开为
[56, 231, 24, 2]的列向量; - 权重矩阵 W 的每一行,分别对应猫、狗、船三个类别的特征权重;
- 执行矩阵乘法
Wx,再加上偏置向量 b,最终得到三个类别的得分:猫 - 96.8、狗 437.9、船 61.95;
模型会选择得分最高的 “狗” 作为预测结果(虽然输入是猫,但这是未训练的随机权重的结果,训练后权重会优化,让猫的得分最高)。
线性分类器是线性模型,只能学习线性决策边界,无法处理复杂的非线性数据(比如图像分类),因此需要在 MLP 中加入激活函数,引入非线性,才能拟合复杂任务。
损失函数
我们在 MLP / 线性分类器中,有两个核心可学习参数:权重 W 和偏置 b。
损失函数的作用,就是衡量模型预测值和真实标签(目标值)之间的差距,给模型的训练提供 “优化方向”:损失越小,说明预测越准;我们的训练目标,就是最小化损失函数,从而找到最优的 W 和 b。
损失函数的选择,完全由任务类型决定,核心分为两大类:
| 任务类型 | 目标输出特点 | 应用场景举例 |
|---|---|---|
| 回归 (Regression) | 连续数值 | 股价预测、降雨量估计、健康监测中的生理数值预测(比如心率、血糖) |
| 分类 (Classification) | 离散标签(类别) | 癌症二分类诊断、人脸识别(多分类)、图像分类、故障检测 |
回归任务常用的损失函数
下式中,$y_i$是真实值,$f(x_i)$是模型预测值。
- 平方损失 (Square Loss)
- 含义:对每个样本的预测误差做平方,再求和,惩罚大误差(误差越大,平方后惩罚越重)。
- 特点:对异常值敏感,适合误差服从正态分布的场景。
- 均方误差 (Mean Square Error, MSE)
- 含义:平方损失的平均值,消除了样本数量 N 的影响,是回归任务最常用的损失函数。
- 特点:可导性好,适合梯度下降优化,直观易解释。
- 平均绝对误差 (Mean Absolute Error, MAE)
- 含义:对每个样本的绝对误差取平均,对异常值的鲁棒性比 MSE 更强。
- 特点:在 0 点不可导,优化难度略高于 MSE,适合存在异常值的回归任务。
分类任务常用损失函数
分类常用softmax损失函数。Softmax 损失 = Softmax 归一化 + 交叉熵损失 (Cross-Entropy Loss),是分类任务的标准损失函数。
- Softmax 归一化
- 作用:把模型输出的原始得分$z_j$(例如上面猫猫例子中的-96.8, 437.9, 61.95),转换为0~1 之间的概率$p_j$,且所有类别的概率和为 1,符合概率的定义。其中j表示第j类,k表示对所有类别进行遍历。
- 特点:放大得分的差距:得分高的类别概率会被进一步放大,得分低的会被压缩,让分类决策更明确。
- 交叉熵损失
- 含义:衡量模型预测概率分布$p_j$和真实标签分布$y_j$之间的差距。
- 真实标签$y_j$是 one-hot 向量:比如真实类别是猫,那么猫对应的$y_j$=1,其他类别$y_j$=0;
- 当模型预测猫的概率$p_j$越接近 1,$\log_ep_j$越接近 0,损失$L$就越小;反之损失越大。
- 特点:可导性好,适合梯度下降优化,是多分类任务的首选损失函数。
举个例子:
下图中,”airplane, automobile”等等都是类别和训练类别所使用的图片。输入上面例子中的猫猫图,得到了输出(z)。
airplane的原始得分是0.7,代入$ p_j = \frac{e^{0.7}}{(e^{0.7}+e^{0.1}+e^{1.6}+e^{2.2}+e^{0.3})}\approx0.109165 $,同理,计算剩余的归一化概率(p)

接着,理想的概率是其他是0,猫猫是1,现实概率是[0.107,0.060,0.269,0.489,0.073],代入交叉熵损失的公式:
CNN 架构
CNN网络主要由卷积层(Convolutional Layer)激活函数层(Activation Function Layer)、池化层(Pooling Layer)、全连接层(Fully-Connected (FC) Layer)和Softmax层构成。

CNN 的核心逻辑非常清晰,分为两大阶段:
- 特征学习阶段:从图像里提取有用特征(上图卷积层到池化层)
- 分类决策阶段:根据提取的特征判断图像类别(全连接层到SOFTMAX层)
卷积层
卷积层的作用是分层提取图像特征。浅层卷积核提取低阶特征(边缘、纹理、颜色),深层卷积核提取高阶特征(物体轮廓、完整目标)。

卷积层用同一个卷积核在图像上滑动提取特征,不用每个像素都训练新参数,大幅减少训练参数量,这是 CNN 比全连接网络高效的原因。换句话说,不同层抽象特征时,权重相同。
图像卷积的操作
输入是宽 × 高 × 通道数的图像(比如 32×32×3 的 RGB 图),卷积核尺寸和输入通道数一致(比如 5×5×3),卷积核在图像上逐位置滑动计算,生成激活图(activation map)。
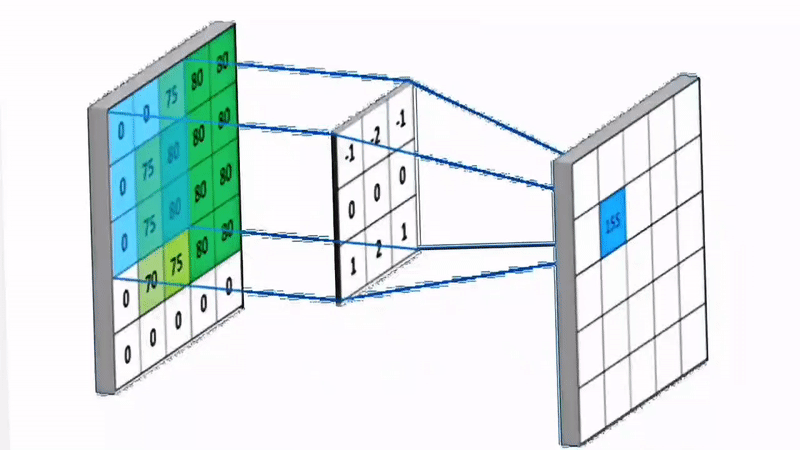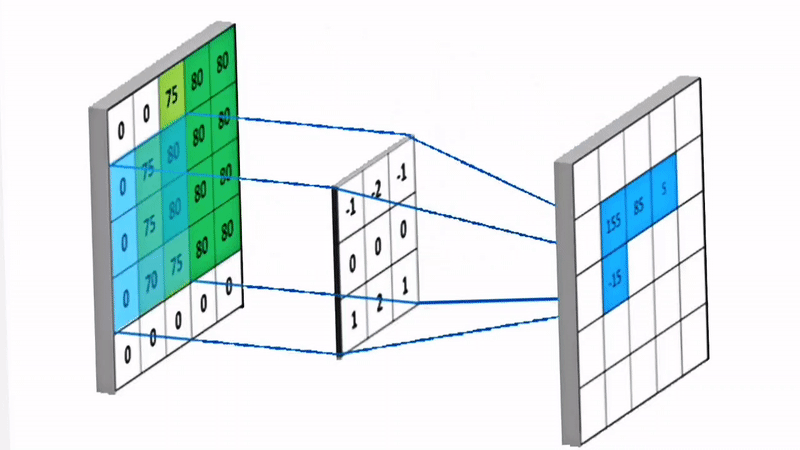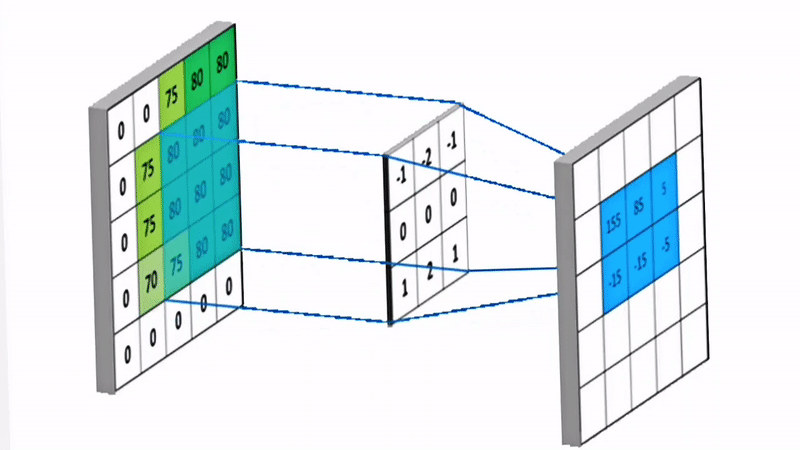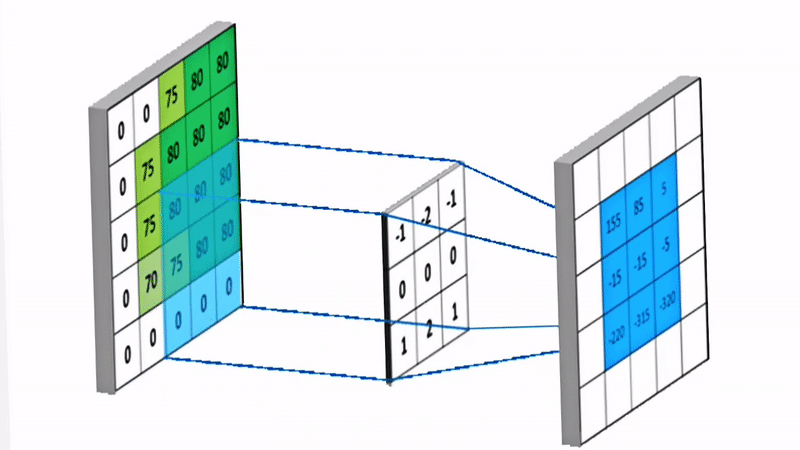
卷积的操作图上图所示,例如其扫描左上角的$\left[\begin{array}{ccc}0 & 0 & 75 \\ 0 & 75 & 80 \\ 0 & 75 & 80\end{array}\right]$,对于上图中的卷积核,其卷积计算的结果就是:
多层卷积与不同卷积核
在进行卷积操作时,就一个要求:输入层的通道数和卷积滤波器的通道数要一致。例如下图,在粉色到蓝色层间,使用了6个 5x5x3的卷积滤波器,每个卷积滤波器都会产生1个通道的数据,因此蓝色层是6个通道。从蓝色层到绿色层,使用的就是10个5x5x6的卷积核。

图像卷积的填充(Padding)
卷积计算会使得图像变小。例如下图所示, 32×32×3 的 RGB 图,经过 5×5×3的卷积核之后,会损失4个像素。

一种避免图像变小的方法就是给图像周围补0,如下图所示,白色格子就是补的0。对于上面这个例子,需要在其边框外补2个0才能保持原尺寸不变($(5-1)/2=2$)。

填充后的卷积例子

卷积的步长(Stride)
卷积核滑动的距离,步长 1 逐像素滑,步长 2 跳像素滑,步长越大,输出尺寸越小。

激活层(Activation Layer)
卷积是线性运算,只能拟合简单规律,必须加激活层引入非线性,才能识别复杂图像。激活层使用一个函数,将每个元素都进行非线性映射。卷积层常与激活层结合使用。
下图是常用的激活函数,RELU是最常用的激活函数之一。

通常来说,激活层被放在卷积结果后,如下图所示,这样得到的激活图就是具备非线性特性的:

池化层(Pooling Layer)
池化层也叫下采样层,核心作用是缩小特征图尺寸,降低激活图的维度,从而降低计算和存储需求。

常用的池化操作有:
- 最大池化:取窗口内最大值,保留图像最突出的特征。
- 平均池化:取窗口内平均值,保留整体特征。
对于激活图的每个通道,池化都独立进行。
下面是一个2x2滤波器最大值池化的例子,对每个2x2的块,都选出其中的最大值,作为池化后输出。

全连接层(FC Layer)
前面卷积、池化输出的是二维特征图,没法直接分类,需要两步:
- 展平(Flatten):把二维特征图拉成一维向量。
- 全连接(FC):每层所有神经元和下一层全连接,将特征向量映射为类别分数,输出的特征也叫「嵌入向量」,可以用来表示整张图像。

FC层和线性分类器中的线性层(Linear Layer)表现类似。
Softmax层
全连接层输出的是原始分数(logits),没法直观判断类别,Softmax 层负责使用Softmax 归一化把分数转化为0-1 之间的概率。

CNN练习题
1.在一个卷积神经网络(CNN)中,输入的 RGB 彩色图像 $I$ 经过一个卷积层,随后是一个激活层。图像 $I$ 的三个通道(红、绿、蓝)定义如下: $I_R, I_G, I_B$。
卷积层具有以下设置:当前的滤波器由下方所示的F给出,图像两侧的零填充量为1,且纵横方向的步长均为2。假设未使用偏置项。
激活层使用 ReLU 函数(即 $f(x) = \max(0, x)$)。
(a) 求卷积层之后的输出。
- $(0,0)=(0\times5)+(-1\times2)+0\times(5+2)=-2$
- $(0,1)=(1\times2)=2$
- $(1,0)=(-1\times2)=-2$
- $(1,1)=(1\times2)=2$
由于 $I_G$ 的原始矩阵全是 $0$,所以填充后依然全是 $0$。
由于输入全为 $0$,无论滤波器 $F_G$ 是什么,卷积结果都为 $0$:
- (0,0) 位置: 窗口中间一行为 $[0, 0, 0]$,则 $(0\times1 + 0\times2 + 0\times1) = 0$
- (0,1) 位置: 窗口中间一行为 $[0, 0, 0]$,则 $(0\times1 + 0\times2 + 0\times1) = 0$
- (1,0) 位置: 窗口中间一行为 $[0, 4, 4]$,则 $(0\times1 + 4\times2 + 4\times1) = 12$
- (1,1) 位置: 窗口中间一行为 $[4, 4, 0]$,则 $(4\times1 + 4\times2 + 0\times1) = 12$
(b) 求激活层之后的输出。
根据激活函数的规则,只有-2被滤掉变成0:
2.一个输入特征向量 $\mathbf{x}$ 通过一个卷积神经网络(CNN)中的全连接层(FC layer),设置如下:
随后对该全连接层的输出应用 Softmax 函数。
(a) 计算全连接层后的输出。
(b) 计算 Softmax 层后的输出。
softmax函数为:
$e^{1.2} \approx 3.320$,$e^{1.3} \approx 3.669$,$e^{2.2} \approx 9.025$。SoftMax函数的分母为:$\sum e^{z_j} = 3.320 + 3.669 + 9.025 = 16.014$
计算每个分量的概率:
- $P_1 = \frac{3.320}{16.014} \approx 0.207$
- $P_2 = \frac{3.669}{16.014} \approx 0.229$
- $P_3 = \frac{9.025}{16.014} \approx 0.564$
CNN训练和优化
训练和优化的目标,是使得损失函数最小。常使用用随机梯度下降(stochastic gradient descent SGD) 及它的变种算法做优化。
其优化流程固定:前向传播算损失 → 损失反向传播算梯度 → 更新网络参数

损失函数:L(W) 是所有样本损失的平均值,衡量模型预测和真实结果的差距
梯度计算:∇W L(W) 是损失对参数的平均梯度,告诉我们参数往哪调能减少损失
参数更新:w(t+1)=w(t)-α∇L(wt),α是学习率,控制参数更新的步长
学习率是训练最关键的超参:
- 学习率太高:模型震荡,根本不收敛
- 学习率太低:收敛极慢,浪费训练时间
- 学习率合适:平稳下降,快速找到最优解

著名的CNN架构
CNN的发展时间线

- 1989/1998:LeNet——CNN 的鼻祖,最早用于手写数字识别
- 2012:AlexNet——引爆深度学习,首次在图像竞赛大幅超越传统方法
- 2014:VGG、GoogleNet—— 加深网络,优化架构
- 2015:ResNet—— 解决深度网络训练难题,里程碑式突破
- 后续:DenseNet、EfficientNet—— 更高效、更轻量化
VGG Network
VGG网络是2014 年图像分类竞赛亚军。它的网络架构小巧优雅,全程用3×3 小卷积核,堆叠深层网络。但其参数量巨大,训练和推理都很耗资源。

常用的变体是VGG-16、VGG-19。
ResNet残差网络
残差网络是2015 年图像分类竞赛冠军。它的核心突破是解决深度网络梯度消失问题,网络能堆到上百层。
梯度消失问题:当你想要训练网络时,需要使用反向传播。反向传播会利用梯度信息,梯度信息它在许多不同的层中进行反向传播,最初梯度很大,但如果层数很多,梯度会变得越来越小。直到到达网络的浅层部分,几乎为0。
下图是这是 ResNet 的典型结构。可以看到左侧有一个输入图像,然后你有很多带颜色的块,这些块被称为残差块。每个残差块输出 = 特征变换 F (x) + 原始输入 x。残差网络直接传递原始参数x的连接被称为”skip connection”,这样梯度可以通过这个连接直接回传,训练超深网络也不会失效

评价CNN的关键性能指标
- 准确率(Accuracy):分类正确的样本占比
- 内存占用:参数 + 激活图的大小,决定模型能不能在设备上运行
- 速度 / 计算量(FLOPS):运算次数越少,推理越快
循环神经网络(Recurrent Neural Network RNN)
引入
对于前面介绍的线性分类器或 CNN,它是一种前馈网络。给定一个当前的图像,它就基于当前图像给你一个输出。这些网络对时间序列数据,或者是状态序列数据的处理并不合适。
我们不妨设计一种新的网络结构,如下图,X是输入,h是hidden state会将输入的特点进行抽象,y是输出。当前的h由当前的输入X和上一次记忆的h共同决定,ABC是不同的转换矩阵。

对于这样的网络,前一个状态的hidden state继续传递到了下一个hidden state,因此它可以处理序列数据。
RNN的典型应用是股票、产品销售预测;自然语言处理如文本翻译,文本情感分类;图像阐述(Image captioning)
序列架构(Sequence Modelling)
一对多映射(One-to-Many Mapping)
1 个输入,输出 1 个序列。一个典型的例子是图像阐述。

如上图,一个长颈鹿的头像被输入CNN,通过CNN输出一组全连接层的特征,将特征注入LSTM网络(RNN网络的一种),LSTM网络尝试预测最有可能出现的第一个单词。从<start>开始,逐词输出描述,最后以<end>结束,比如图中的Giraffes standing....。
多对一映射(Many-to-One Mapping)
输入 1 个序列(多个输入),输出 1 个结果。经典的案例有:
- 视频分类:输入视频的连续帧序列,输出 1 个视频类别标签;
- 情感分类:输入一句话的单词序列,输出 1 个情感标签(积极 / 消极)。
多对多映射(Many-to-Many Mapping)
输入 1 个序列,输出 1 个等长 / 可变长序列。经典的案例有:
- 机器翻译:输入一种语言的单词序列,输出另一种语言的单词序列;
- 逐帧视频分类:输入视频帧序列,输出每一帧对应的标签序列。
有意思的是下面这个图。假设这是一个机器翻译的神经网络,但是它并非是一个输入进去之后立马就输出,而是等3个输入都被输入进去了,才开始产生输出。这是因为在翻译这类应用中,需要结合上下文进行理解,所以必须要累积一定的输入。

编码器与解码器架构
假设我们的目标是,给定一个特定的英语句子,我们想把它翻译成法语或德语句子。那我们该怎么做呢?
首先,对于我们现有的这些英语单词,我们会进行嵌入(Embed)操作。嵌入操作意味着对于这里的每个单词,将其转换成一个向量,因为计算机并不知道单词是什么。它只理解向量表示。之后,让它通过一个例如循环神经网络,它能做的是提取这些信息,并将其压缩成一个上下文向量。这个上下文向量将包含这句话的重要信息,这就是编码器的目标。

相应的,解码器的作用是进行解码,或者生成或预测下一个单词。
一句话说:编码器将输入信息压缩成某种上下文向量。利用这个上下文向量,通过解码一次生成一个输出。这就是编码器-解码器架构
RNN架构
结构
下图是 RNN 的结构(左:折叠形式)(右:展开形式)

每个时间步,用上一步的旧隐藏状态+当前输入向量,通过带参数W的函数,计算出新的隐藏状态;
隐藏状态层的更新
隐藏状态层的更新公式为:
其中:
- $h_t$:是新的状态函数
- $x_t$:当前输入
- $h_{t-1}$:前序状态
- $f_W$:映射函数
输出的生成
输出可以表示为:
即,当前输出由当前的隐藏状态经过函数变换得到。
基础RNN(Vanilla RNN/Elman RNN)
这是最原始、最简单的 RNN,也叫普通 RNN或Elman RNN(以发明者 Jeffrey Elman 教授命名)。
其中,$W_{hh}$是hidden to hidden 权重矩阵,$W_{xh}$是input to hidden权重矩阵. $tanh$是激活函数

RNN的例题
一个原生循环神经网络 (RNN) 具有以下设置:
- *初始隐藏状态 (Initial hidden state): $h_0 = \begin{bmatrix} 0 \\ 0 \end{bmatrix}$*
- *隐藏层权重矩阵 (Hidden state weight matrix): $W_{hh} = \begin{bmatrix} 0.1 & 0.2 \\ 0.3 & 0.4 \end{bmatrix}$*
- *输入层权重矩阵 (Input weight matrix): $W_{xh} = \begin{bmatrix} 0.5 & 0.2 \\ 0.2 & 0.1 \end{bmatrix}$*
- *输出层权重矩阵 (Output weight matrix): $W_{hy} = \begin{bmatrix} 0.1 & 0.4 \end{bmatrix}$*
- 假设在计算中不使用偏置 (No bias)。
- 一个 2 步长的输入为: $x = [x_1, x_2]$,其中 $x_1 = \begin{bmatrix} 3 \\ 4 \end{bmatrix}$,$x_2 = \begin{bmatrix} 1 \\ 6 \end{bmatrix}$。
(i) 计算时间步 $t=1$ 时的隐藏状态 $h_1$。
(ii) 计算时间步 $t=1$ 时的输出 $y_1$。
(iii) 计算时间步 $t=2$ 时的输出 $y_2$。
RNN的优势和劣势
优势:
- 可以处理任意长度的输入:无论是一句话、一段音乐还是一个时间序列,无论其长度是 10 个词还是 1000 个词,RNN 的结构都可以通过循环处理,逐个接收输入,理论上没有长度限制。
- 理论上,第 t 步的计算可以利用前面很多步的信息:从理论上讲,模型有潜力捕捉到序列中长距离的依赖关系,比如一句话中开头和结尾的关联。
- 模型大小不会随着输入长度的增加而增加:无论输入序列有多长,模型始终使用同一套权重矩阵(
W_hh,W_xh,W_hy)。这意味着模型的复杂度(参数量)是固定的,不会因为处理更长的句子或时间序列而变得更庞大 - 每个时间步都应用相同的权重,因此处理输入的方式具有一致性:对于序列中的每个元素(比如每个单词),模型都用相同的方式去理解和处理它。这保证了模型在处理序列时的行为是一致的,比如在处理 “我爱你” 和 “你爱我” 时,对 “爱” 这个词的处理方式是相同的,这符合我们对语言的理解。
缺点:
- 循环计算速度慢:RNN 的计算是串行的。它必须先处理完第
t-1步,才能得到h_{t-1},进而处理第t步。 - 在实践中,难以利用前面很多步的信息:虽然理论上 RNN 可以记住很久以前的信息,但在实际训练中,由于梯度消失或梯度爆炸的问题,模型很难学习到长距离的依赖关系。
RNN训练和优化
训练原理
RNN 的训练,它与 CNN 类似。训练和优化的目标,是使得损失函数最小。常使用用随机梯度下降(stochastic gradient descent SGD) 及它的变种算法做优化。
看到下面这张图,在RNN中,$h$的每一步转移都使用同一个转移矩阵$W$。而每一步隐藏层都能生成一个对应的$y$,这些y和在一起构成输出序列。使用样本进行训练时,样本也是一个序列,所以每一个$y_i$和样本都有一个损失值$L_i$。优化的目标是使得总的L最小。

RNN在进行反向传播时,传播方向是与时间轴相反的,因此称其为Backpropagation Through Time(BPTT)。如果你想训练一个包含很长序列的 RNN,比如文本或时间序列非常长,那么它需要很长的训练时间。因为对于一次迭代来说,需要和正向传播路径等长的传播。

为了加快训练过程,通常人们会尝试将输入分割成不同的块或片段:隐藏状态一直向前传播,但是反向传播只传播一小段。这被称为Truncated Backpropagation Through Time。这样可以显著提升训练效率

梯度爆炸与梯度消失
下图是RNN训练时的一个系统图。我们可以将输入的$x$和前序状态$h$拼在一起,同时也对$W_{hh}$和$W_{xh}$执行一些变换,使它合成一个矩阵$W$,最后拼在一起的向量乘上W等价于$W_{h h} h_{t-1}+W_{x h} x_{t}$。此时我们需要对这个W进行训练

在对损失求梯度时,由于损失是各个$y_t$的损失加起来的,因此有:
我们考虑$t=T$时的这一项,它经过线性代数上的化简可以得到:
其中$W_{h h}^{T-1}$这一项很特殊,它与自身相乘 T-1 次。这个矩阵的最大奇异值(老师说不需要搞懂这是个啥玩意,线代里面的)会直接影响到梯度。
- 如果最大奇异值(Largest singular value )> 1:梯度会指数级增长,最后梯度爆炸(Exploding gradients)。
- 解决梯度爆炸的方法是,如果梯度过大,则将它直接cut到最大值。
- 如果最大奇异值(Largest singular value )< 1:梯度会指数级减少,最终梯度消失(Vanishing gradients)
这是 RNN 模型的一个关键问题。而且,梯度消失还会造成另一个问题:最初梯度会比较大,但随着时间的推移,梯度会变得越来越小,这意味着这些输入对当前的记忆影响很小。也就是RNN的记忆力不好。
长短期记忆网络(Long Short-Term Memory LSTM)
为了RNN解决消失的梯度问题的不足,人们发明了LSTM,它是RNN的变体。LSTM的中文应该读作长(短期记忆)网络,指的是它可以拥有较长的短期记忆。
LSTM的结构
LSTM的结构图下图。LSTM中,定义了一种被称为细胞,它能够在很长一段时间内保持状态的记忆状态。

在上图中:
- $C_t$:Cell state 细胞状态,负责长期记忆;$h_t$:隐藏状态,负责短期记忆;
- $X_t$:输入数据;$(i,f,o,g)$:四个候选门(gates),他们实际是一个向量
其中,由$f$驱动的叫遗忘门;$i$驱动的是输入门,$g$是候选记忆(下图$\hat c_t$);$o$驱动的是输出门。下面会详细阐述它的工作机理

LSTM更新的公式如下:($\odot$表示向量点乘!)
先来看遗忘门的工作原理
细胞状态的当前$c_{t} =f \odot c_{t-1}+i \odot g$:
- 如果遗忘门$f$是全1向量或值接近于1,那么上一步的记忆细胞$c_{t-1}$就将被完整或大部分保留。
- 如果遗忘门f是全0向量或值接近于0,那么上一步的记忆细胞$c_{t−1}$就将会被大部分遗忘。
输入门和记忆候选的工作原理
$c_{t} =f \odot c_{t-1}+i \odot g$,在确保细胞该忘的都忘了,该记的都记着之后,就要开始写入新东西了。写入新东西由$i \odot g$决定
- $i$就是希望朝长期记忆中写入的新东西
- $g$是决定$i$当中的数值写入多少的控制向量
输出门与短期记忆
短期记忆$h(t)$是由$c(t)$转化而来的,$h_{t} =o \odot \tanh \left(c_{t}\right)$。这里面的$o$决定了有多少长期记忆会被转化为短期记忆。
四个门的更新方式
- 把上一时刻隐藏状态和当前时刻输入拼在一起:$\left(\begin{array}{c} h_{t-1} \\ x_{t} \end{array}\right)$
- W实际是由4个子矩阵组成的,第一个子矩阵关系到$i$,第二个关系到$f$,第三个关系到$o$,第四个关系到$g$。$W=$$\left(\begin{array}{c} W_{i} \\ W_{f} \\ W_{o} \\ W_{g} \end{array}\right)$
- 对于$i,f,o$,都是使用输入乘上对应的控制矩阵后,用$\sigma$函数激活。例如:
- 对于$g$,它的激活函数是$\tanh$
若记忆向量的长度是h,那么各矩阵大小为:

LSTM练习题
一个长短期记忆网络 (LSTM) 具有以下设置:
*初始隐藏状态 (Initial hidden state): $h_0 = \begin{bmatrix} 0 \\ 0 \end{bmatrix}$*
*初始细胞状态 (Initial cell state): $c_0 = \begin{bmatrix} 0.1 \\ 0.2 \end{bmatrix}$*
遗忘门权重矩阵 (Forget gate weight matrix):
*在时间步 $t=1$ 时的输入门 (Input gate): $i_1 = \begin{bmatrix} 0.3 \\ 0.4 \end{bmatrix}$*
*在时间步 $t=1$ 时的候选状态/门门 (Gate gate): $g_1 = \begin{bmatrix} 0.5 \\ 0.6 \end{bmatrix}$*
*在时间步 $t=1$ 时的输出门 (Output gate): $o_1 = \begin{bmatrix} 0.4 \\ 0.6 \end{bmatrix}$*
*在时间步 $t=1$ 时的输入 (Input): $x_1 = \begin{bmatrix} 2 \\ 1 \end{bmatrix}$*
假设在 LSTM 的计算中不使用偏置项 (bias)。Sigmoid 和 tanh 函数定义如下:
(i) 计算在时间步 $t=1$ 时的遗忘门 $f_1$。并对你得到的结果进行评价/简评。
前一个cell state大部分都得到保留。
(ii) 计算在时间步 $t=1$ 时的细胞状态 $c_1$。
Transformer
注意力(Attention)
是什么
在Transformer 中,关键概念之一是注意力机制。
注意力是什么呢?
比如当你提到“mouse”这个词时,当你使用“mouse”这个词时,它到底是什么意思呢?是指电脑鼠标,还是指老鼠这种动物呢?因此,为了更好地理解“鼠标”这个单词,你需要了解上下文信息。
注意力是 Transformer 模型的核心创新,本质是让模型学会 “重点关注” 输入中与当前任务相关的信息,就像人读句子时会重点关注和当前词相关的上下文,而不是平均分配注意力。
注意力机制用于判断哪些输入 token(比如 NLP 中的单词、CV 中的图像块)与当前输入 / 当前 token 相关。
例如下面这个例子,对于这个it,Attention根据上下文找出了其他token中和这个it相关性最高的是animal。

怎么算
它通过两个向量之间的相关性(点积运算)来计算,用点积计算两个向量的相关性,相关性直接等价于两个 token 的相似度 / 关联性 / 重要性。把这些相关性归一化后,就得到了每个 token 的注意力权重,权重越高,模型越关注这个 token。
每一个输入的token都会被生成3个向量: query (q), key (k) 和value (v)。将input的编码成向量(下图绿色),然后分别和$W^Q$, $W^K$,$W^V$相乘,即可得到对应的k,q,v。

- Query (q):就像你在图书馆输入的搜索词,表示“我现在要找什么”。(即,提出问题,找相关)
- Key (k):相当于每本书的索引标签,表示“这本书的主题是什么”。(即,负责被匹配)
- Value (v):就是书的实际内容,真正包含的信息。(即,提供详细信息)
注意力计算的步骤是:
- 用点积计算q和k之间的相关性;
- 对步骤1中的相关性值归一化后用Softmax函数进行放缩
- 将步骤2归一化的值乘以其对应的value(v)并求和
例如下面这个例子:

现在要识别关于Thinking这个词的相关token,首先,计算得出qkv后:
thinking自己的分值:thinking的q乘thinking的k
thinking和Machines的分值:thinking的q乘machines的k
将计算后的值除以向量维度的平方根来归一化$/\sqrt{d_k}$,然后使用Softmax进行转化为0-1之间的值。
- 归一化的值乘对应token的value并求和,就得到了上下文向量z。例如上图的例子中$z_1=0.88\times V_1+0.12\times V_2$
然而,在真实计算时,并不会这样一步一步地计算
一步到位的计算公式是:

可以看到,这和我们前面的计算步骤完全一致。这个Z矩阵的第一行就是前图中的$z_1$,第二行就是$z_2$。
例题
在一个应用中,一名学生想要对由 2 个时间步组成的输入数据进行自注意力计算,输入数据如下:
查询矩阵(Query)、键矩阵(Key)和值矩阵(Value)分别给出如下:
(a) 求输入 $\mathbf{x}_1$ 对应的查询向量 ($\mathbf{q}_1$) 和键向量 ($\mathbf{k}_1$)。
(b) 求输入 $\mathbf{x}_2$ 对应的查询向量 ($\mathbf{q}_2$) 和键向量 ($\mathbf{k}_2$)。
(c) 计算 $\mathbf{q}_1$ 与 $\mathbf{k}_1$ 之间的点积。
(d) 计算 $\mathbf{q}_1$ 与 $\mathbf{k}_2$ 之间的点积。
(e) 比较并讨论输入 $\mathbf{x}_1$ 的注意力分数(Attention scores)。
因为 $1.58 > 0.85$,这表明在当前的自注意力机制配置下,输入向量 $\mathbf{x}_1$ 给予自身的注意力权重远高于给予 $\mathbf{x}_2$ 的权重。
Transformer架构
Transformer 是一种使用注意力机制,并行处理输入数据的AI模型。它:
- 高度并行化
- 能够提供全局注意力(不会因为上下文过长丢失关系)
- 擅长建模长距离依赖关系
Transformer是许多视觉和NLP中性能最好的模型,它还推动了其他算法,例如BERT。
引入:编码器与解码器
Transformer最开始是为了机器翻译而生的。它采用前面介绍的Encoder-Decoder架构,在输入端输入文字后,每个文字在Ecoder中生成kqv值,然后被融合成上下文向量吐出来。这些上下文向量带有Attention机制,含有与他强有关联的token的信息。Decoder负责将Encoder吐出的向量解码,生成一个一个的结果吐出来。

如上图所示,Transformer并不只使用单个Encoder,而是使用一连串的Encoder,每个编码器只进行一点转换,这样,每个编码器的任务就会稍微容易一些。对于Decoder,同理。
如果我们放大看Encoder的内部,它实际有两个部分组成:自注意力+前馈网络。如下图

对于编码器,假设输入时3个法语字符:
- 经过Self-Attention之后,会生成3个上下文向量(Context Vector)。
- 经过前馈网络产生一次函数映射,和MLP一样,对Context Vector进行一次改良(前馈网络是一种通用的函数映射,总是可以让映射或函数变得更好一点)
对于解码器:
- 解码器有两个输入,一个来自于编码器,一个来自于它自己。假如对3个法语字符的翻译它已经完成了2个,那么现在完成的2个字符就会作为解码器的输入。
- 解码器将自己的输出经过自注意力层化为上下文向量
- 来自编码器的向量和解码器已经输出的向量被输入到Encoder-Decoder 注意力层(或称交叉注意力层)。这一层存在的原因是:Encoder输入是三个法语单词,你的输出是三个法语上下文向量,Decoder输入是两个英语单词,这个自注意力层之后的输出是两个英语上下文向量。完成翻译要查看法语单词之间的关系,然后你还要查看英语单词之间的关系,还要查看法语和英语单词之间的关系。交叉注意力层就是为了注意到法语和英语单词之间的关系。
- 经过交叉注意力后,输出是两个上下文向量,向量经过前馈网络,产生当前decoder的输出
Transformer架构总览
正如前面提到的,transformer基于编码器-解码器架构。它的架构图如下图所示,左侧是编码器,右侧是解码器。

Transformer中的自注意力层
现在,我们来看看编解码器内部。编码器由输入自注意力+神经网络构成,解码器由Output Masked Self-Attention+交叉注意力+神经网络构成。和前面介绍的结构一致,为什么输出的自注意力是masked会在后面详细阐释。

对于输入自注意力层:
- 其接受输入$X=[X_1,X_1,X_1…,X_m]$
- 输入自注意力的上下文向量$C_X=Attn(X,X)$
- $W_Q$,$W_K$,$W_V$是需要被训练的参数

对于交叉注意力层(Cross Attention Layer):
- $X’$是输出自己吐出去的东西
- 它计算的是解码器的q去查询输入的k的关系,输入的上下文向量c是由关系乘上输入的v,如下图所示。

多头注意力(Multi-head attention)
多头注意力为什么叫“多头”?就像一个人看问题,可能只看到:语法关系或者语义关系,二选一,这样做不全面!
而所谓多头注意力,把自注意力层复制很多次,每一层都具有 $W_Q, W_K, W_V$ ,分别关注不同信息。例如Head1:关注语法;Head2:关注语义;Head3:关注指代关系。最后把他们输出的内容向量组合成一个更长的向量,这样就可以面面俱到了。

注意力掩码
为什么解码器这边是masked的多头注意力呢?
因为生成句子时不能偷看未来。举个例子:假设目标句子是:I love you
训练时我们其实是这样喂给模型的(右边Decoder那部分):输入(shifted) I love;目标 I love you
问题来了:当模型在预测 “love” 时,如果它能看到 “you”,那就等于提前看答案了。 所以必须限制:
- 第1个词只能看自己
- 第2个词只能看前2个
- 第3个词只能看前3个…
所谓mask在 attention 的分数矩阵里,把未来位置“屏蔽掉”
先看没有 Mask 的 attention
Attention 的核心是$QK^T$,按照上面介绍的,$K$是由输出矩阵得来的(包含参考答案)。
假设序列长度 = 4,得到:每个词都能看所有词 (不符合生成规则)
1 | 看谁 → |
加 Mask(下三角矩阵)
1 | t1 t2 t3 t4 |
这就是 causal mask(因果掩码)
位置编码(Position Encoding)
由于Transformer是并行处理,Transformer 本身没有“顺序感”。但是说话是有先后顺序的。因此需要给每个输入数据都打上位置标签。即,给每个词的 词向量 (embedding) 加上一个 位置向量 (positional encoding)。这样,模型在看到词的时候,不仅知道它的语义,还知道它在句子里的位置。
对于Transformer,它使用sin和cos来进行位置编码。在原始论文 Attention Is All You Need 中,位置编码定义如下:
对于位置 (pos) 和维度 (i):
其中:
- (pos):词在句子中的位置(第几个词)。
- (i):向量的维度索引。
- (d_{model}):词向量的总维度(比如 512 或 768)。
- 偶数维度用 sin,奇数维度用 cos。
sin 和 cos 是周期函数,能自然表达“相对位置”。比如第 5 个词和第 6 个词的编码差异,模型能感受到它们相邻。
嵌入的过程就是直接把原始数据向量和位置向量相加,如下图。

残差连接与层归一化
在一个编码器内,存在残差连接,它利用了 Resnet 中的残差学习思想。
层归一化用于执行规范化

Transformer架构总览

最终的线性层和输出层
解码器的输出最后会传入一个线性层,线性层会生成每个预测词的几率;通过softmax归一化之后,在词库里面挑出几率最大的,就是输出的下一个词。

Vision Transformer
传统 CNN 是通过卷积核在空间上提取局部特征。
ViT 的突破点在于:把图像切成小块(patch),每个 patch 当作一个“词”,然后用 Transformer(原本用于 NLP 的注意力模型)来处理这些视觉“词”。

1.图像分块 (Patch Partitioning)
- 把输入图像切成固定大小的 patch,例如 16×16 像素。
- 如果图像是 224×224,那么会得到 14×14=196 个 patch。
2.展平与线性映射 ( Linear Projection of Flatten Patches)
- 每个 patch 展平成一个向量。
- 通过一个线性层,把这些向量映射到统一的维度(embedding dimension)。
3.加入分类 token (Class Token)
- 在序列最前面加一个特殊的可学习向量,类似于 BERT 的 [class] token。
- 这个 token 的最终输出会作为整张图像的分类结果。
4.位置编码 (Positional Embedding)
- 因为 Transformer 本身不懂顺序,所以要加上位置编码,告诉模型这些 patch 在图像中的位置。
5.放到Transformer Encoder中,执行识别:之前添加的class token会在这个步骤学习到其他token的信息。最后只把这个token输入MLP,就可以得到图像的分类。
例题:(b)用户希望开发一个图像分类应用程序,该应用程序使用一个能够实: 现良好准确性的模型,并在进行分类时使用注意机制。他正在考虑以下三个候选型:(i)VGG,(ii) Vision Transformer (ViT)和 (iii) 长短时记忆(LSTM)。说明哪种模式最有可能满足用户的需求,并简要说明你的答案。
答案: 视觉Transformer (ViT)。
- 视觉Transformer(ViT)基于Transformer架构,使用注意力机制,能够实现非常好的准确率。
- VGG是一种不利用全局注意力的CNN。它使用卷积层逐步提取高层次的抽象特征。
- LSTM是一种使用记忆机制来分析序列数据的模型。因此,它不适合用于图像分类应用。